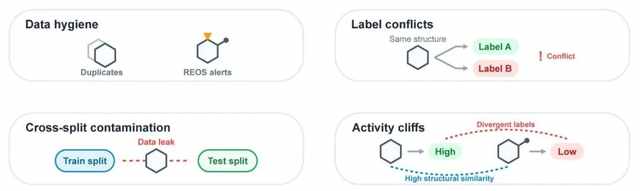
新加坡国立大学的张阳教授从事 AI 驱动的治疗药物发现研究,其中包括数据库建设和基准设计。他说:“如果发生数据泄漏,训练集和测试集相似或存在重复,模型表现就会变得远好于实际情况。这是一个常见问题。这篇论文的价值在于,它跨越许多不同数据库和方法,对这个问题进行了定量检查。”什么才算缺陷,还要看模型准备解决什么问题英国帝国理工学院的 Pedro Ballester 教授评论说:“根本问题在于,许多基准没有与某个特定应用场景明确关联。”Ballester 的工作是开发并应用计算方法促进生物医学发现,其中包括虚拟筛选的基准测试。他指出,在先导化合物优化过程中预测活性时,相似分子可能是合适的;但在虚拟筛选中,模型可能需要具备把结果推广到化学结构不同的化合物上的能力。Schuh 及其同事目前呼吁研究人员报告测试集的具体组成,并对基准数据集开展常规审计。为此,他们创建了开源工具 BenchAudit,用于识别训练—测试污染和标签冲突等问题。Schuh 表示,他们的目标并不是消除每一个缺陷,而是“提高认识,并尽可能保持诚实”。
References: M G Schuh, A Daniluk and S A Sieber, Chem. Sci., 2026, DOI: 10.1039/d6sc01799a