《自然·医学》:面向多样化医疗应用的开放式视觉–语言模型
Nat. Med. | 面向多样化医疗应用的开放式视觉–语言模型
摘要
Nature Medicine 发表研究介绍 DRUGONE 开放式视觉–语言模型,可处理医学影像、电子健康记录、临床文本及生物医学知识等高度异质性医疗数据,支持疾病识别、临床推理、影像报告生成等多种医疗任务,为多样化临床应用场景提供统一 AI 基础框架。
AI 主编 · 推荐理由推荐理由
AI 医疗软件监管正加速推进,该研究展示了多模态视觉–语言模型在临床场景的能力边界,注册与质量部门可借此评估同类 AI 医疗产品的技术路径与验证要求,提前布局审评应对策略。
五维评分
正文
DRUGONE
人工智能在医疗领域展现出巨大潜力,但医疗数据具有高度异质性,涵盖医学影像、电子健康记录、临床文本及生物医学知识等多种形式。同时,医疗任务涉及疾病识别、临床推理、影像报告生成和患者管理等不同场景,对模型的准确性、隐私保护与可扩展性提出了更高要求。通用多模态大模型虽然已经具备较强的视觉理解和语言推理能力,但往往缺乏对专业医学知识与复杂临床情境的深入理解。
为解决这一问题,研究人员开发了 MedGemma,一组基于 Gemma 3 构建的开放式医疗视觉–语言基础模型,旨在通过医学领域预训练和后训练,提高模型对不同医疗影像和文本任务的适应能力。MedGemma 包含40亿参数的多模态模型、270亿参数的多模态模型以及270亿参数的纯文本模型。同时,研究人员提出 MedSigLIP,一种经过医学领域优化的4亿参数视觉编码器,为 MedGemma 提供跨医学影像类型的视觉表征能力。
在医学知识问答、胸部X线影像分类、病理图像识别、皮肤病诊断、视网膜图像分析、临床推理及医学智能体等任务中,MedGemma 相比相同规模的通用 Gemma 3 模型取得了明显提升。在分布外任务中,医学视觉问答性能提高2.6%–10%,胸部X线异常分类提高15.5%–18.1%,智能体评估提高10.8%。此外,针对具体医学任务进行微调能够进一步提高性能,尤其在训练数据有限时表现出明显优势。研究表明,开放式医学基础模型可以为不同医疗场景提供统一且可定制的人工智能底座,从而降低医疗人工智能应用的开发成本。
现代医疗体系每天产生大量不同类型的数据,包括放射影像、数字病理切片、皮肤病图像、眼底照片、电子健康记录和临床报告等。这些数据往往分散于不同设备和医疗系统中,但疾病诊断与治疗决策需要综合多个来源的信息。因此,能够同时理解医学图像和文本的多模态人工智能模型,被认为是推动医疗信息整合和辅助临床决策的重要技术方向。
近年来,大语言模型和视觉–语言模型在自然语言理解、图像识别与复杂推理方面取得快速发展。然而,通用模型通常以互联网文本和自然图像为主要训练来源,面对医学影像中的细微异常、专业术语以及复杂诊疗路径时,可能缺乏必要的领域知识。另一方面,专门针对胸部X线、病理或眼科等单一领域训练的模型虽然能够获得较高性能,却难以直接迁移至其他医疗任务,导致不同应用需要重复开发独立模型。
开放式基础模型为这一问题提供了新的解决思路。研究人员可以在共享模型架构的基础上,利用少量任务特异性数据进行微调,而不必从头训练大型医疗模型。相比仅通过远程接口访问的闭源模型,开放权重模型还可以部署在本地环境中,使医疗机构更容易控制敏感数据、模型参数和计算成本。
因此,本研究的目标并非针对某一种疾病开发单独的分类器,而是构建能够覆盖多种医学影像和文本任务的通用医疗基础模型,在保持一般语言能力的同时,强化专业医学理解,并验证这种领域专门化是否能够在不同任务中形成稳定的性能优势。
方法
研究人员以 Gemma 3 为基础构建 MedGemma 模型家族,包括 MedGemma 4B、MedGemma 27B 和 MedGemma 27B Text。其中,前两者能够同时处理图像和文本,后者专门优化医学文本推理。视觉部分采用 SigLIP-400M 编码器,并利用数百万医学图像–文本配对数据进行医学领域适配,形成 MedSigLIP。训练数据覆盖胸部X线、CT和MRI二维切片、数字病理、皮肤病学、眼科学以及临床文本,同时混合通用领域数据,以减轻医学专门化造成的通用能力下降。
在视觉编码器优化之后,研究人员进一步调整语言解码器,使其能够理解新的医学视觉特征,并通过包含医学文本、图像问答和临床任务的后训练过程增强模型能力。训练采用知识蒸馏和强化学习等策略,保留 Gemma 3 的长上下文和图文交错输入能力。随后,研究人员在医学文本问答、医学图像分类、开放式临床推理、视觉问答、胸部X线报告生成、医学智能体以及通用任务中系统评价模型。对于任务特异性适配,则使用低秩微调和强化学习,比较 MedGemma 与原始 Gemma 3 在完整训练数据和少量数据条件下的表现。
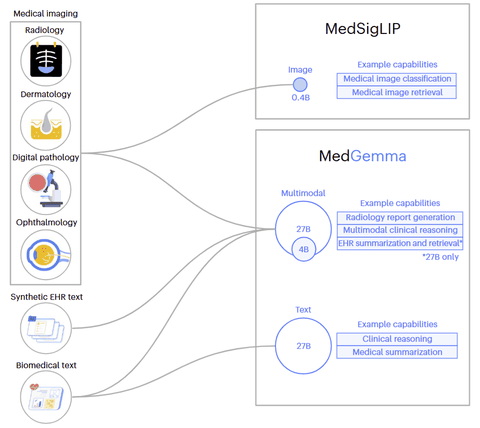
图1|MedGemma模型家族及其面向多种医学影像和临床文本任务的整体架构。
结果
MedGemma在医学文本理解与临床知识问答中表现突出
研究人员首先使用 MedQA、MedMCQA、PubMedQA、MMLU医学子集及 MedXpertQA 等基准测试模型对专业医学知识的理解能力。总体结果显示,医学领域训练显著提高了不同参数规模模型的医学问答表现。
在 MedQA 测试中,MedGemma 4B 的准确率达到64.1%,明显高于 Gemma 3 4B 的52.4%。更大规模的 MedGemma 27B Text 达到86.2%,而相同规模的 Gemma 3 27B 为74.9%。在 MedMCQA 中,MedGemma 27B Text 同样由基础模型的62.6%提高至72.4%。这些结果说明,在不必大幅增加模型规模的条件下,医学领域专门训练能够带来显著的知识和推理能力提升。
研究人员还评估了模型识别医学错误信息的能力。在 MedHallu 基准中,模型需要区分正确回答与表面合理但实际错误的医学陈述。MedGemma 4B 的归一化得分达到0.50,明显高于基础 Gemma 3 4B 的0.09。在由医生评价的开放式医学问答中,MedGemma 4B 的事实性错误回答比例从18.5%下降至15.4%,相对减少约17%。
不过,医学专门化并不意味着小模型在所有任务中都能够超过最先进的大规模闭源模型。例如在部分高难度医学推理基准上,更大规模模型仍具有明显优势。因此,MedGemma 的主要价值在于其参数规模与性能之间的平衡,以及作为下游医学任务基础模型的适应能力。
医学视觉编码器提升跨影像类型的理解能力
研究人员随后评估 MedGemma 对多种医学图像的分类能力,涵盖胸部X线、数字病理、皮肤病和视网膜图像。与一般自然图像不同,这些医学图像在结构、颜色、尺度及病理表现上存在巨大差异,因此能够在单一视觉编码器中同时处理多种医学图像,是模型通用性的重要体现。
在胸部X线分类任务中,MedGemma 4B 在 MIMIC-CXR 测试集上的宏平均F1分数达到88.9%,高于 Gemma 3 4B 的81.2%;MedGemma 27B 则达到90.0%。在分布外 CheXpert 和 CXR14 数据集中,MedGemma 4B 分别获得48.1%和50.1%的宏平均F1分数,而对应基础模型仅为32.6%和32.0%。
在数字病理 PathMCQA 中,MedGemma 4B 和27B准确率分别为69.8%和71.6%,相比基础模型的37.1%和42.2%获得显著提高。皮肤病分类中,MedGemma 4B 达到71.8%,视网膜 EyePACS 分类则达到64.9%,27B版本进一步提升至75.3%。
这些结果表明,针对医学领域训练的视觉编码器能够跨越不同影像模态学习具有判别价值的特征。特别是在病理和视网膜图像中,领域适配带来的收益非常明显。研究人员进一步将 MedSigLIP 作为独立视觉编码器进行评价,发现其在零样本分类、少样本适配和医学图像检索中,也能够达到与多种专门医学图像编码器相当甚至更好的性能。
MedGemma能够执行开放式医学视觉问答与临床推理
相比传统分类任务,医学视觉问答要求模型将图像中的异常表现与临床知识结合,并通过自然语言生成回答。研究人员利用 SLAKE、VQA-RAD 和 MedXpertQA 等基准评估 MedGemma 的开放式多模态能力。
结果显示,MedGemma 相比基础 Gemma 3 获得更好的视觉问答表现,并在多个测试中接近参数规模更大的闭源模型。研究人员还展示了胸部X线、皮肤病和数字病理的实际问答案例,以说明模型如何从医学影像中提取关键信息,并形成可解释的诊断描述。
在胸部X线案例中,MedGemma 4B 识别出左侧气胸及胸腔引流管,并对其他影像表现进行描述。在皮肤病案例中,模型根据皮损形态推测基底细胞癌,并建议进一步就诊皮肤科。在病理图像案例中,模型识别出高级别浸润性癌的主要形态特征,包括细胞异型性、明显核仁和增多的有丝分裂活动。
这些案例说明,MedGemma 不仅能够给出分类标签,还能够生成与医学观察相关的描述和推理。不过,图像问答中的开放式表达仍可能出现遗漏或不精确判断,因此其临床可靠性需要结合具体任务开展进一步验证。
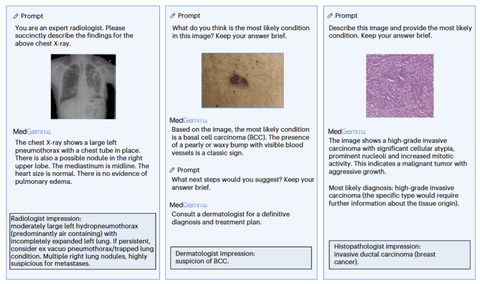
图2|MedGemma 4B在胸部X线、皮肤病和数字病理图像上的开放式多模态问答示例。
胸部X线报告生成体现模型的临床文本生成能力
胸部X线报告生成是医学视觉–语言模型最具代表性的应用之一。模型不仅需要识别图像中的异常,还需要以放射科报告的形式组织观察结果,并给出临床意义明确的总结。
在 MIMIC-CXR 数据集中,未经任务特异性微调的 MedGemma 4B 已获得29.5%的 RadGraph F1分数,接近多个专门开发的影像报告生成模型。通过进一步使用强化学习优化报告生成任务,模型的 RadGraph F1 提高至30.3%,在研究所比较的同时生成影像发现和诊断印象的模型中取得较高表现。
在人工临床评价中,正常胸片生成报告中有68%被认为与原始报告质量相当或更好,异常胸片报告中这一比例为49%。进一步从潜在临床决策影响出发评价时,81%的生成报告被认为可能支持与原始报告相同或更好的临床决策。
这一结果说明,医学视觉–语言模型已经能够生成具有一定临床实用价值的影像文本,但在异常病例中仍存在明显提升空间。相比正常图像,异常胸片往往包含多个病理表现及其相互关系,对模型的完整性和准确性提出了更高要求。
医学智能体与通用任务验证模型的综合适应能力
为评估模型是否能够支持更复杂的临床工作流程,研究人员进一步使用 AgentClinic 基准,将 MedGemma 作为模拟医生智能体,要求其通过病史采集、检查信息理解和诊断推理完成临床任务。
结果显示,MedGemma 27B 在 AgentClinic-MedQA 任务中的表现超过基准中的人类医生,并在部分智能体评估中接近规模更大的模型。相比之下,MedGemma 4B 在较复杂的智能体环境中存在指令遵循困难,说明较小模型虽然适合影像分类和医学问答,但在需要多步骤规划及持续交互的任务中仍受到能力限制。
研究人员还使用 MMLU Pro、Global MMLU Lite 和 MMMU 等通用基准检验医学领域训练是否损害模型的一般能力。结果显示,MedGemma 相比相同规模的 Gemma 3 仅出现较小性能下降,说明其在获得医学专业知识的同时,基本保留了通用语言理解与多模态推理能力。
这种能力平衡十分重要,因为真实临床应用往往并不是纯粹的医学知识问答,还需要模型理解普通语言指令、处理跨领域信息,并与其他软件和工作流程进行协作。
医学领域预训练提高了小样本微调效率
MedGemma 的设计目标并不是让未经调整的基础模型直接完成所有医疗任务,而是为不同下游应用提供统一的高质量起点。为验证这一点,研究人员选择训练阶段未使用过的胸片气胸分类、结直肠病理组织分类和皮肤病灶分类数据,比较 MedGemma 4B 与 Gemma 3 4B 的微调表现。
总体上,两种模型均可通过微调提高性能,但 MedGemma 在大多数情况下获得更好的最终结果。尤其当仅使用10%的训练数据时,MedGemma 的优势更加明显,说明医学领域预训练能够降低特定医疗任务对大量标注数据的依赖。
在气胸分类任务中,通用 Gemma 3 容易退化为预测占比最高的类别,而 MedGemma 能够避免这种现象,提示其预先学习的放射影像知识可以改善有限数据条件下的模型稳定性。
研究人员还在电子健康记录问答任务中使用强化学习优化 MedGemma 27B Text。结果显示,模型在需要跨多个相互关联病历记录进行推理的问题上获得更明显提升。这说明 MedGemma 的能力不仅来自预训练中的医学知识积累,也可以通过后续任务优化进一步适应具体医疗流程。
讨论
MedGemma 的主要贡献在于证明,通用基础模型与医学领域专门化并不是相互排斥的方向。通过对视觉编码器、语言模型预训练和后训练进行协同优化,研究人员建立了一组能够覆盖放射影像、数字病理、眼科、皮肤病学以及医学文本的开放式模型。与针对单一疾病或单一模态分别开发模型相比,这种统一基础模型能够降低重复训练和系统整合的成本,并支持在相同框架下快速开展新的医疗人工智能应用。
另一项重要发现是医学领域专门化具有明显的参数效率优势。在多个医学视觉任务中,规模较小的 MedGemma 甚至能够接近或超过参数量更大的通用模型。与此同时,开放权重和本地部署能力使医疗机构有机会在自身数据环境中进行适配、验证和推理,减少对外部远程服务的依赖。这对涉及患者隐私、数据治理以及长期模型维护的医疗场景尤为重要。
不过,这项研究也存在明确限制。首先,模型主要针对二维医学图像进行优化,尚未充分覆盖完整三维CT和MRI体数据。其次,在部分病理任务中,专门训练的视觉编码器仍然能够达到更高性能,说明通用医学模型尚不能替代所有领域专用工具。此外,不同医学基准在数据来源、评价指标和任务定义方面存在差异,公开数据集还可能存在训练污染风险,因此基准分数不能直接等同于真实临床表现。
更重要的是,医学人工智能的实际应用不仅取决于准确率,还需要持续评估事实性错误、群体偏差、模型可靠性和患者安全。尽管 MedGemma 在多个任务中表现出较强能力,模型仍可能生成错误或遗漏重要医学信息,因此临床部署前必须进行场景特异性的严格验证,并建立适当的人工监督机制。
总体而言,MedGemma 与 MedSigLIP 展示了一种兼顾医学专业能力、计算效率、开放性和可定制性的基础模型路线。其价值不仅在于获得较高基准性能,更在于为研究人员和开发者提供一个能够跨多种医疗任务复用的统一底座,为医学人工智能从单任务模型走向多模态、可扩展和可适配的系统奠定基础。
整理 | DrugOne团队
参考资料
Sellergren, A., Kazemzadeh, S., Mahvar, F. et al. An open vision-language model for diverse medical applications. Nat Med (2026).
https://doi.org/10.1038/s41591-026-04626-w
内容为【DrugOne】公众号原创|转载请注明来源