Nat. Mach. Intell. | 融合分子对接与组合组装策略的大型蛋白质复合物结构预测方法
摘要
DRUGONE大型蛋白质复合物的准确结构预测对于理解细胞信号转导、物质运输及基因调控等生物学过程具有重要意义。然而,由于大型复合物通常包含大量蛋白质亚基及复杂的链间相互作用,AlphaFold等端到端
正文
DRUGONE
大型蛋白质复合物的准确结构预测对于理解细胞信号转导、物质运输及基因调控等生物学过程具有重要意义。然而,由于大型复合物通常包含大量蛋白质亚基及复杂的链间相互作用,AlphaFold等端到端深度学习方法仍面临显存限制和预测精度下降的问题。传统分子对接方法虽然能够处理较大体系,但其计算复杂度随着亚基数量增加而迅速增长;组合组装方法则高度依赖预先预测的局部亚复合物结构质量。
研究人员提出了HDOCK-Multimer(HDM),一种融合分子对接与组合组装的大型蛋白质复合物结构预测框架。该方法通过整合非对称对接、对称对接及基于遗传算法的组合组装策略,在充分利用局部亚基相互作用信息的同时,降低对初始亚复合物结构准确性的依赖。
研究人员在包含35个大型异源复合物、172个大型蛋白质复合物及7个CASP15靶标的三个基准数据集上开展系统评估。结果显示,HDM在整体结构预测准确率和大规模复合物建模能力方面显著优于CombFold、MoLPC及AlphaFold-Multimer,并在多项评估中超过AlphaFold 3。此外,HDM还能够在缺乏预先给定化学计量比的情况下,通过结构组装和能量评分推断亚基拷贝数。该研究为突破大型蛋白质复合物结构预测中的规模限制和组装精度瓶颈提供了有效方案。
蛋白质通常通过形成多亚基复合物执行生物学功能,包括细胞内物质运输、信号传递、基因表达调控及代谢反应等。准确解析这些复合物的三维结构,有助于理解蛋白质之间的分子识别机制,并为疾病相关靶标研究和药物设计提供结构基础。
然而,大型蛋白质复合物通常包含多个相同或不同的蛋白质亚基,其空间排列具有复杂的对称性和多体相互作用。冷冻电子显微镜和X射线晶体学虽然能够解析部分大型复合物,但实验成本较高,且受到样品稳定性、结构异质性和实验分辨率等因素的限制。
近年来,AlphaFold系列模型显著提高了蛋白质结构预测精度。AlphaFold-Multimer能够直接预测多链复合物,但随着亚基数量和序列长度增加,其预测准确性和计算效率通常下降。例如,在40 GB显存的NVIDIA A100 GPU上,AlphaFold-Multimer v2能够处理的体系规模约为3,300个氨基酸残基。AlphaFold 3虽然进一步提高了复合物建模能力,但仍受到输入规模和显存容量限制。
为了突破端到端预测方法的规模瓶颈,研究人员提出了基于局部亚复合物的组装策略。MoLPC利用蒙特卡洛树搜索组装局部结构,而CombFold采用层次化组合组装方法探索亚基之间的空间排列关系。
这类方法能够处理比端到端模型更大的体系,但其成功高度依赖局部亚复合物的预测质量。一旦初始亚基界面存在错误,偏差就可能在组装过程中不断累积,最终导致整体结构预测失败。
另一方面,传统蛋白质分子对接能够直接探索亚基之间的相互作用,但在多链体系中面临组合空间爆炸的问题。如何结合对接方法的构象搜索能力与组合组装方法的高效率,成为大型蛋白质复合物预测的重要研究方向。
方法
研究人员开发了HDOCK-Multimer框架,以蛋白质复合物的亚基序列作为输入,通过三个连续阶段生成完整复合物结构。首先,利用AlphaFold 2和AlphaFold-Multimer预测单体及三聚体亚复合物结构,并根据结构置信度筛选代表性模型。随后,根据复合物的亚基组成、同源性及对称性特征,动态选择非对称对接、对称对接或组合组装策略。非对称对接采用迭代式多体对接逐步构建复合物,对称对接显式考虑循环、二面体、四面体和八面体对称性,而组合组装则利用局部亚复合物提取的亚基间相对位姿,通过随机采样和遗传算法优化完整结构。对于初始组合组装未能成功构建的体系,进一步引入多体对接完成剩余结构。所有候选模型通过分子动力学松弛减少原子碰撞,并使用基于蛋白质相互作用的IT-score评分函数排序,随后根据主链均方根偏差进行聚类,默认输出排名前十的结构。研究人员在三个独立基准数据集上,利用TM-score和DockQ评价预测精度,并通过消融实验、不同对称类型分析、界面新颖性分析及化学计量比预测验证各模块的贡献。
结果
HDOCK-Multimer整合分子对接与组合组装实现大型复合物建模
研究人员首先建立了一种根据复合物结构特征自动选择建模策略的统一框架。与传统方法采用单一结构组装算法不同,HDM综合利用非对称对接、对称对接及组合组装,以适应不同大小、组成和空间对称性的蛋白质复合物。整个流程首先根据输入序列预测单体及三聚体亚复合物。研究选择三聚体作为主要局部结构单元,是因为它能够捕获比二聚体更加丰富的协同相互作用,同时避免四聚体预测带来的额外计算成本与显存压力。
随后,HDM根据复合物组成选择不同策略。对于同源多聚体,系统优先评估其对称性,并采用针对循环、二面体、四面体和八面体结构的对称对接。对于包含少于五种不同亚基的体系,可以采用非对称多体对接;对于包含五种及以上不同亚基的复合物,则主要通过组合组装重建完整结构。
在组合组装阶段,HDM从预测的亚复合物中提取亚基相对空间关系,通过随机组合生成初始结构,再利用遗传算法对候选组装方案进行交叉、突变和优化。最终结合分子动力学松弛及IT-score评分筛选合理构象。
这一设计使HDM能够在利用AlphaFold预测局部界面信息的同时,通过额外的对接采样修正潜在错误,从而降低对单一局部结构预测结果的依赖。
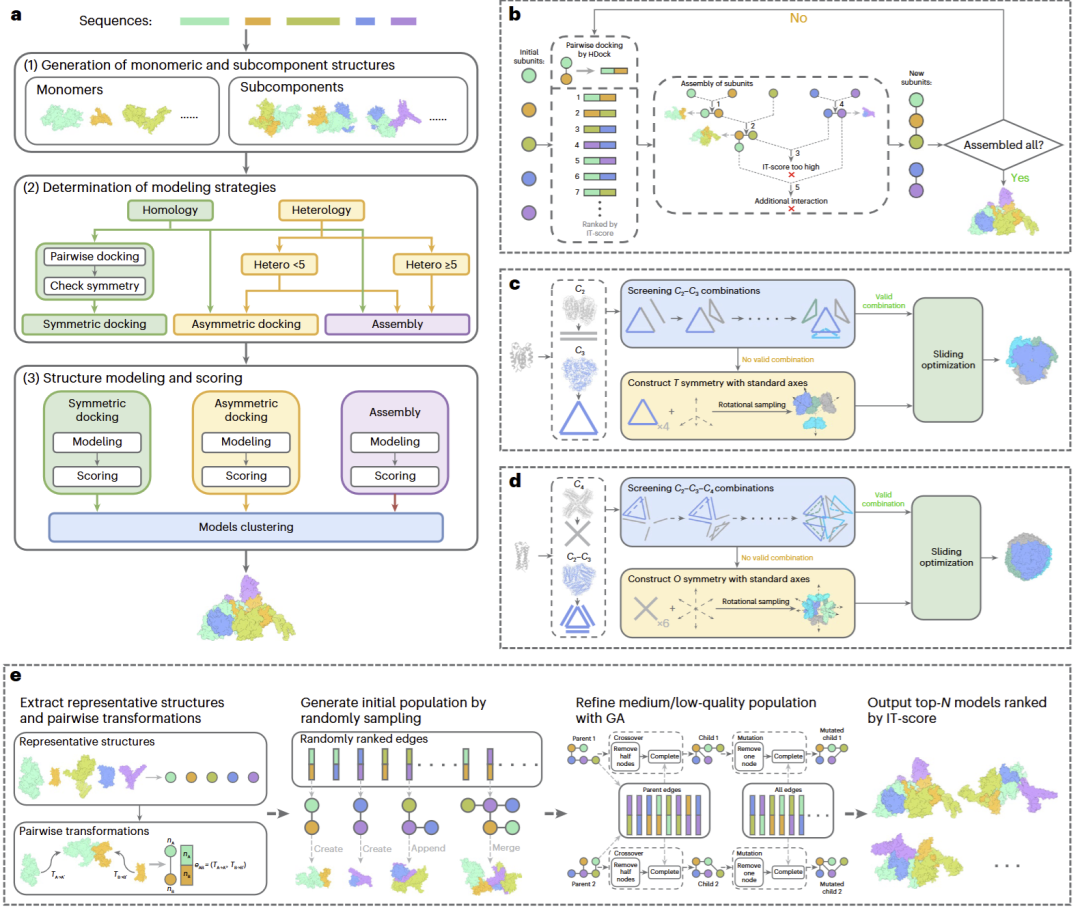
图1|HDOCK-Multimer整体框架及非对称对接、对称对接与遗传算法组合组装流程。
在35个大型异源复合物中显著优于现有结构预测方法
研究人员首先在包含35个大型异源蛋白质复合物的Benchmark 1数据集上评估HDM性能。这些复合物包含5–20条蛋白质链,能够反映复杂异源多亚基体系的结构预测难度。
以TM-score衡量整体结构质量,HDM的Top-1预测在可接受精度和高质量标准下分别达到83%和66%的成功率。相比之下,CombFold分别为74%和54%,MoLPC仅为29%和11%,AlphaFold-Multimer v2则为29%和26%。
在采用DockQ评估亚基界面质量时,HDM同样表现出明显优势。其Top-1和Top-10预测达到可接受界面精度的成功率分别为86%和89%,高于CombFold的80%和86%,以及MoLPC和AlphaFold-Multimer的对应结果。
逐一比较发现,HDM的主要优势并非全面提高已有高质量预测的精度,而是能够在其他方法预测失败的体系中恢复正确的整体结构。
例如,对于Polytomella复合物I(PDB 7ARC),HDM预测结构的TM-score达到0.85,而CombFold和MoLPC分别仅为0.64和0.32。结构叠合显示,其他方法主要由于部分亚基排列错误而降低整体精度,HDM则能够恢复更加准确的亚基空间位置。不过,在eIF2B–eIF2复合物中,CombFold的预测仍优于HDM,说明组合组装过程中错误的局部界面选择仍可能影响结果。
这些实验表明,融合对接与组合组装能够有效改善大型异源复合物的整体结构预测,尤其适用于局部亚基关系难以直接准确推断的复杂体系。
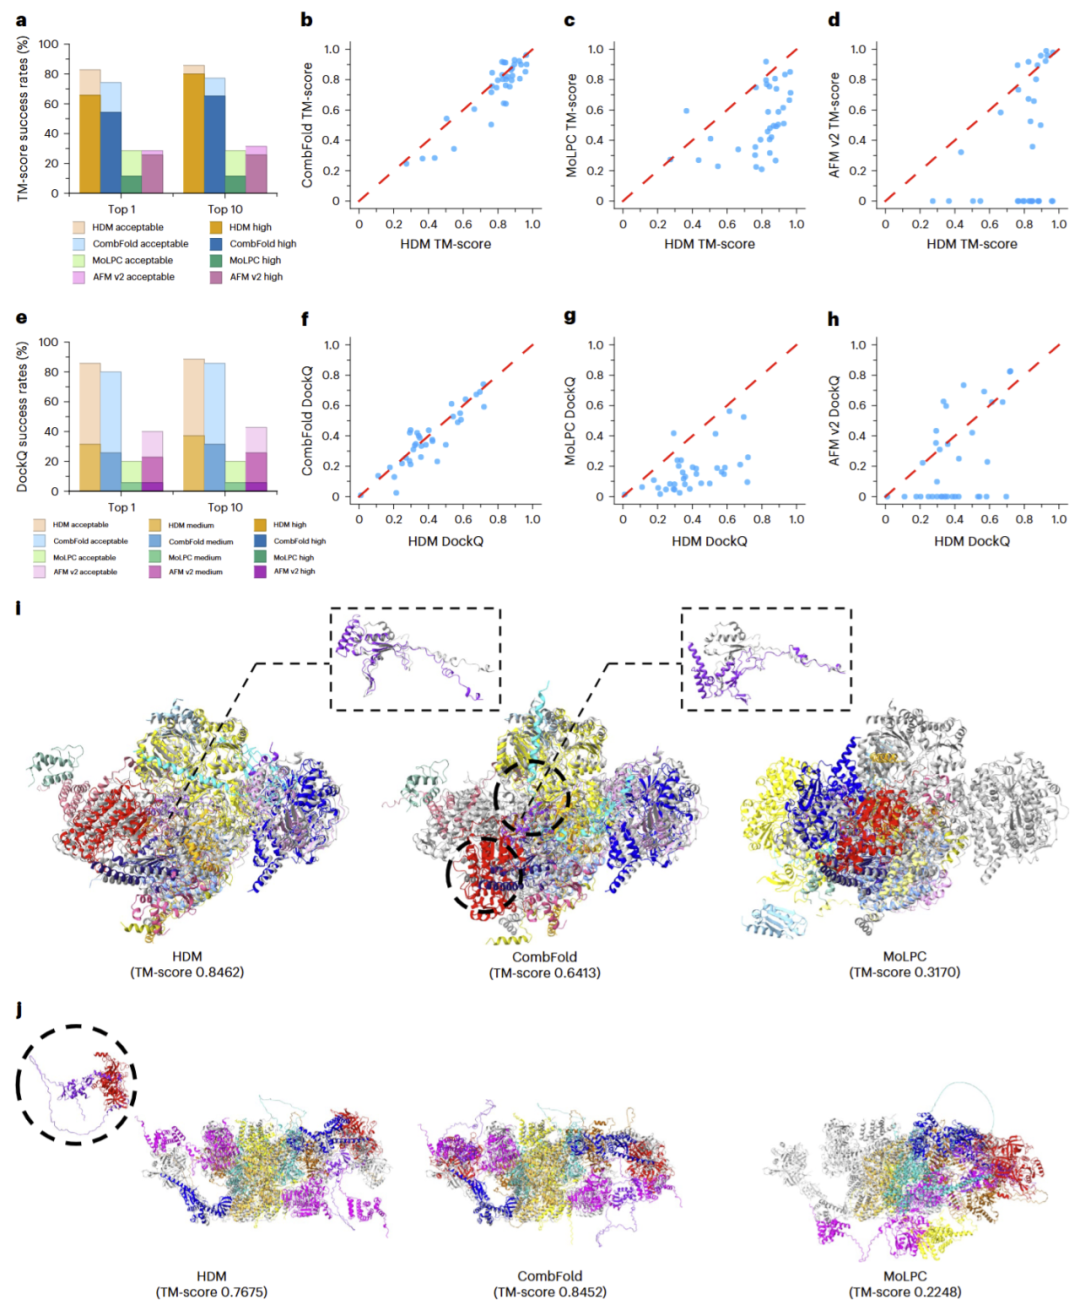
图2|HDOCK-Multimer在35个大型异源蛋白质复合物上的预测表现及与现有方法的比较。
在172个大型蛋白质复合物中展现更好的准确率与规模扩展能力
为了进一步验证方法的适用范围,研究人员在Benchmark 2中测试了172个大型蛋白质复合物,其中包含114个同源多聚体和58个异源多聚体,每个复合物由10–30条蛋白质链组成。
实验结果显示,HDM的Top-1和Top-10结构预测成功率分别达到59%和66%,明显高于CombFold的41%及MoLPC的30%。AlphaFold 3的Top-1和Top-5成功率分别为55%和58%,同样低于HDM的相应整体表现。
在界面质量方面,HDM的Top-1和Top-10可接受精度成功率分别达到66%和73%,优于CombFold的47%和49%,以及MoLPC的38%。
值得注意的是,AlphaFold 3在部分能够完整建模的复合物上生成了更高质量的蛋白质界面,说明端到端深度学习模型仍具有较强的局部界面预测能力。然而,由于输入规模限制,AlphaFold 3仅能处理172个复合物中的145个。
在一个包含7,062个氨基酸残基的工程化羧化酶复合物(PDB 6YBQ)中,该体系已超过AlphaFold 3服务器的输入限制,但HDM仍获得TM-score为0.98的高质量结构,并为实验结构中未解析的区域补充了2,749个氨基酸残基。此外,对于人GCN5组蛋白乙酰转移酶相关复合物,HDM通过八面体对称对接获得TM-score为0.91的预测,而AlphaFold 3未能成功恢复正确结构。
这些结果表明,HDM不仅在整体结构预测成功率方面具有优势,还能够突破端到端方法对输入残基数量的限制,为超大型蛋白质复合物建模提供可扩展方案。
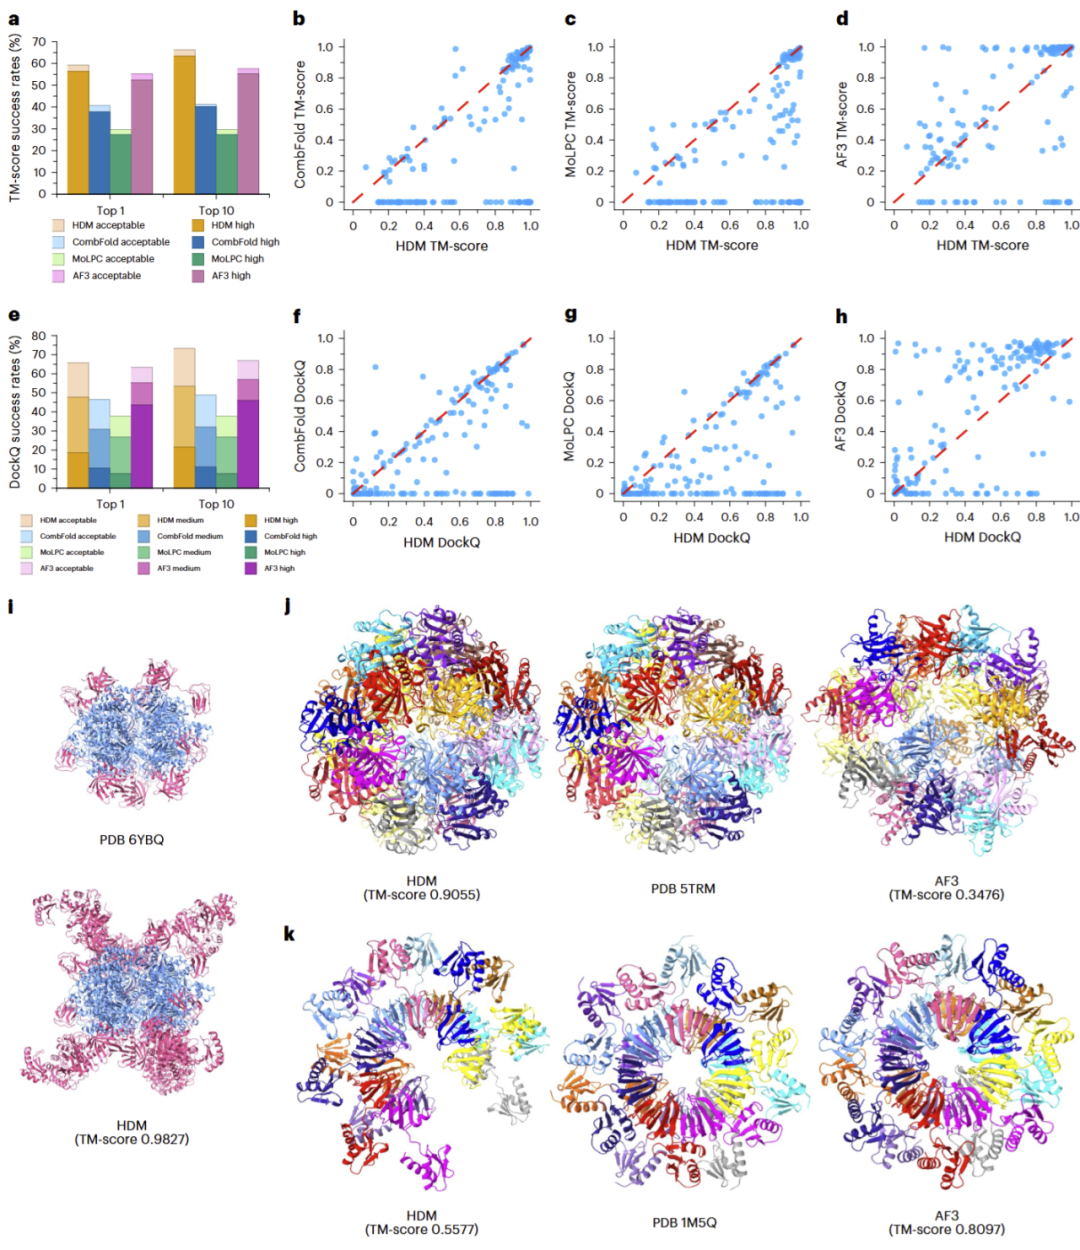
图3|HDOCK-Multimer在172个大型蛋白质复合物中的预测精度、界面质量及大规模结构建模能力。
CASP15真实靶标验证HDM对复杂组装结构的泛化能力
为进一步评估HDM在实际结构预测任务中的表现,研究人员选择CASP15中的7个复杂靶标作为独立测试集,包括同源和异源多聚体,以及包含超过3,000个氨基酸残基的超长蛋白质。实验显示,HDM成功为7个靶标中的6个生成达到可接受精度的结构,整体成功率达到86%。
对于RAD52复合物,HDM获得TM-score为0.87的预测;对于YscY–YscX–LcrD复合物,TM-score达到0.91;在天然蚊唾液腺表面蛋白SGS1体系中,预测结果同样达到0.81。对于部分复杂结构,HDM能够准确恢复局部组装单元,但仍难以直接重建完整复合物。例如,在Huc氢化酶复合物中,HDM得到TM-score为0.98的高质量局部亚复合物预测,而非完整结构。
对于MceG复合物,直接使用全长蛋白链进行建模并不成功。研究人员通过人工划分蛋白质结构域,分别组装不同局部结构,再利用重叠区域进行对齐与分子动力学松弛,最终获得TM-score为0.78的完整预测。与其他方法相比,MoLPC和AlphaFold-Multimer分别仅在3个和1个靶标上获得成功,HDM与CombFold则具有相同的86%成功率。
这些结果表明,HDM能够适应具有复杂对称性、多个结构域及超长蛋白质链的真实复合物,但其性能仍受到结构域划分和初始亚复合物质量的影响。
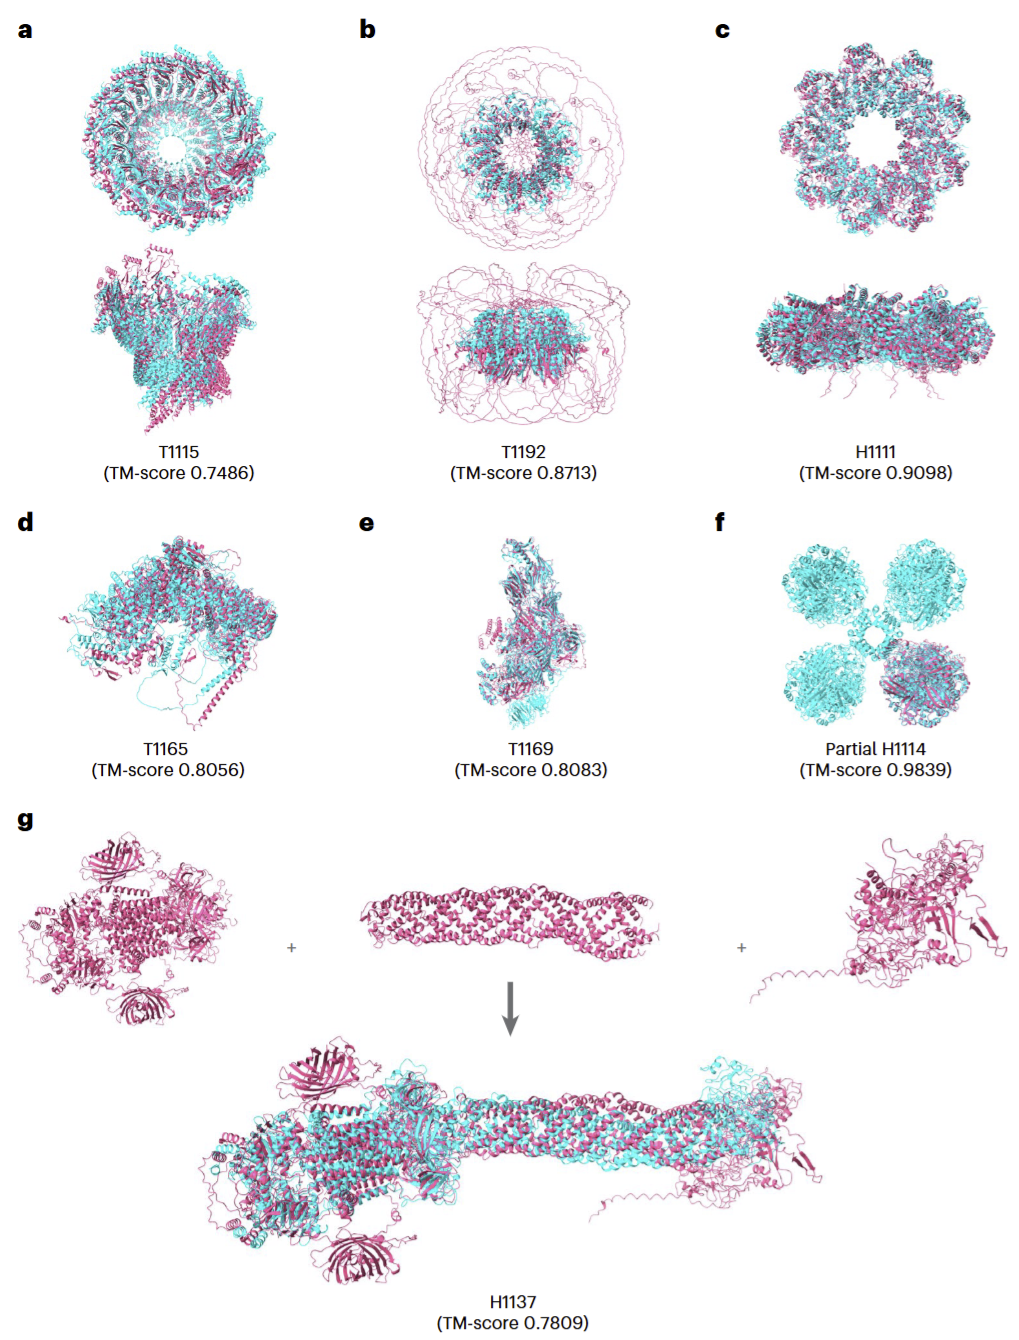
图4|HDOCK-Multimer在CASP15大型蛋白质复合物靶标上的结构预测与实验结构比较。
多种建模策略的协同作用是提高预测性能的关键
为了明确HDM性能改善的来源,研究人员开展系统消融实验,分别分析遗传算法、分子动力学松弛、IT-score评分及不同对接策略的贡献。
结果显示,即使仅使用基础组合组装策略,HDM的预测效果也已经优于MoLPC和CombFold,说明其采样和候选结构筛选过程能够更加有效地探索亚基排列空间。
在此基础上,引入遗传算法能够进一步增加具有可接受精度的候选结构数量。分子动力学松弛虽然没有直接明显提高整体预测成功率,但可以减少原子间空间冲突,为后续评分提供更加合理的结构。IT-score排序则进一步提高了正确结构出现在前列候选中的概率。
研究人员还比较了非对称对接、对称对接、组合组装及组装后重新对接等策略。结果发现,单独采用多体对接的性能相对有限,而在组合组装后增加重新对接能够显著改善部分预测失败的体系。
例如,对于核黄素合成酶RibH2复合物(PDB 2OBX),直接组合组装只能生成两个局部五重对称亚复合物,而进一步通过多体对接连接这些结构后,最终获得TM-score为0.98的完整复合物。在不同对称类型的比较中,HDM对循环、二面体、四面体及八面体对称复合物均表现出良好的建模能力。对称复合物的Top-1成功率达到64%,而非对称复合物仅为33%,说明明确利用对称性约束能够显著降低复杂组装的搜索难度。
这些结果证明,HDM的优势来自多种建模策略的互补,而非某个单独模块的改进。
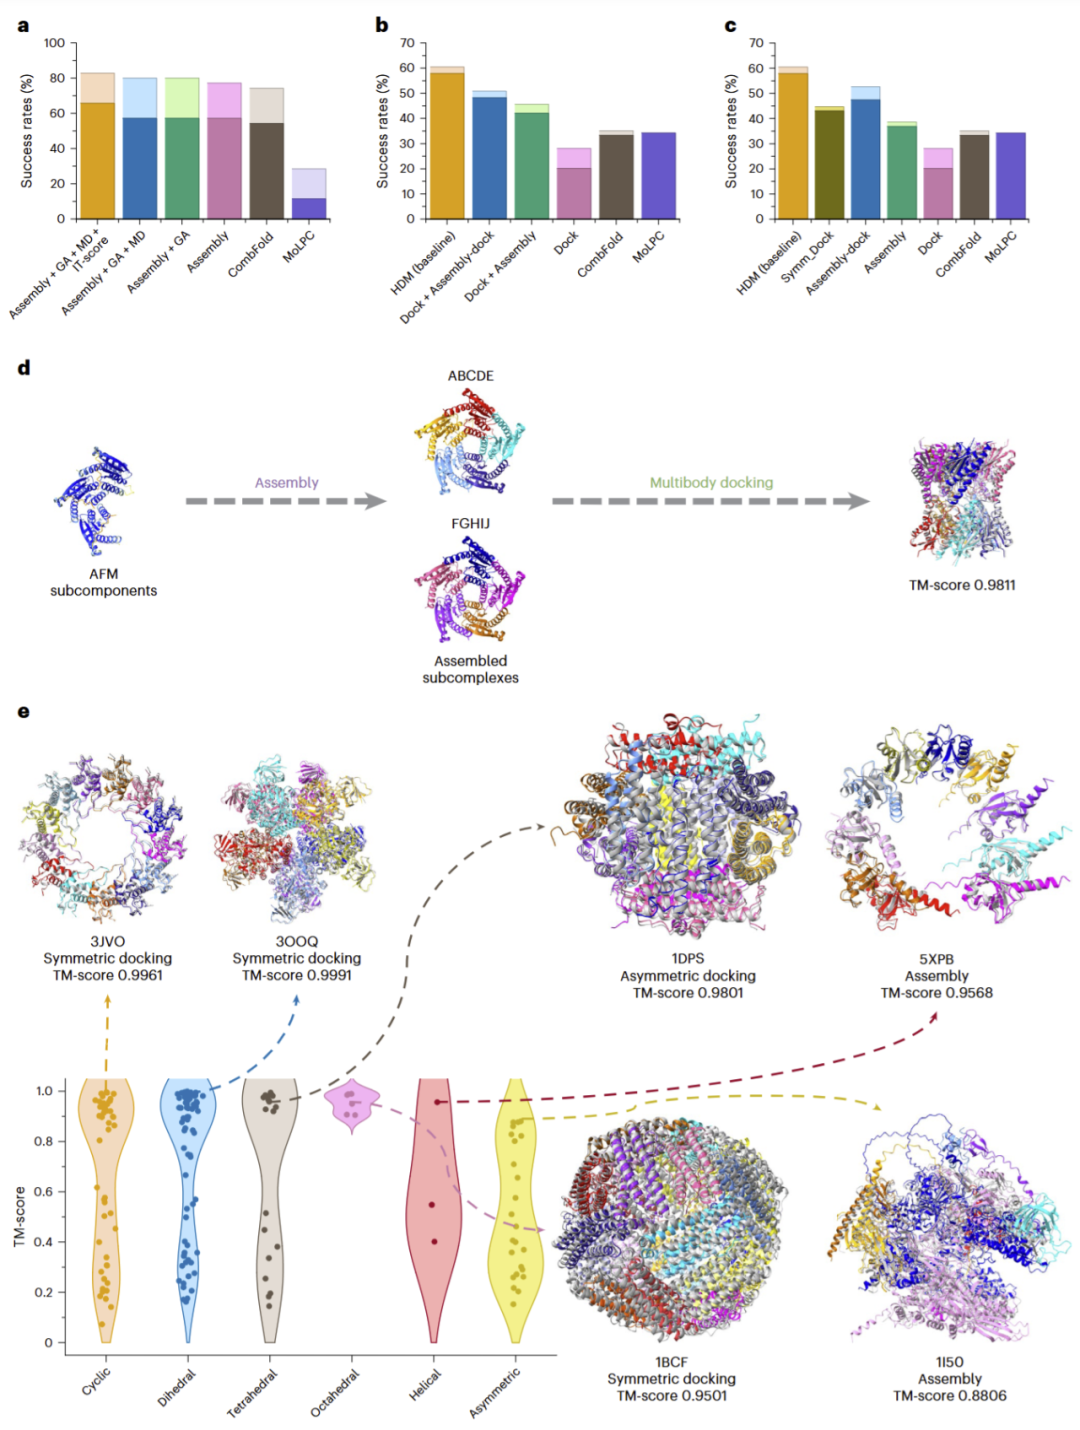
图5|不同建模策略及关键算法模块对HDOCK-Multimer结构预测性能的贡献。
无需预先给定亚基拷贝数即可推断复合物化学计量比
除预测已知组成的蛋白质复合物外,研究人员进一步探索HDM是否能够在缺乏精确化学计量比信息的情况下推断亚基拷贝数。
传统组合组装方法通常需要预先指定复合物包含多少个亚基,但在实际生物学研究中,这一信息并不总是已知。因此,研究人员尝试通过枚举不同亚基拷贝数组合,并评估组装结构的置信度及IT-score评分,确定最合理的复合物组成。
在20个代表性复合物中,采用归一化IT-score能够正确识别14个复合物的化学计量比,而使用模型置信度评分仅正确识别9个。例如,对于牛ATP合酶Fo结构域(PDB 6ZBB),HDM能够在不同亚基拷贝数下构建候选结构,并通过评分识别正确的8拷贝局部对称组装。
在酵母ATP酶c10环状复合物(PDB 4F4S)中,模型置信度在多个候选拷贝数之间缺乏明显区分能力,而归一化IT-score能够正确识别由10个亚基组成的环状结构。进一步分析发现,当候选拷贝数超过合理范围时,部分体系由于严重的空间冲突无法完成组装。这表明,结构几何兼容性本身也能够提供化学计量比约束。
不过,HDM目前只能基于已有局部结构和相互作用信息推断相对合理的组装组成,尚不能完全替代质谱等实验技术对绝对化学计量比的测定。
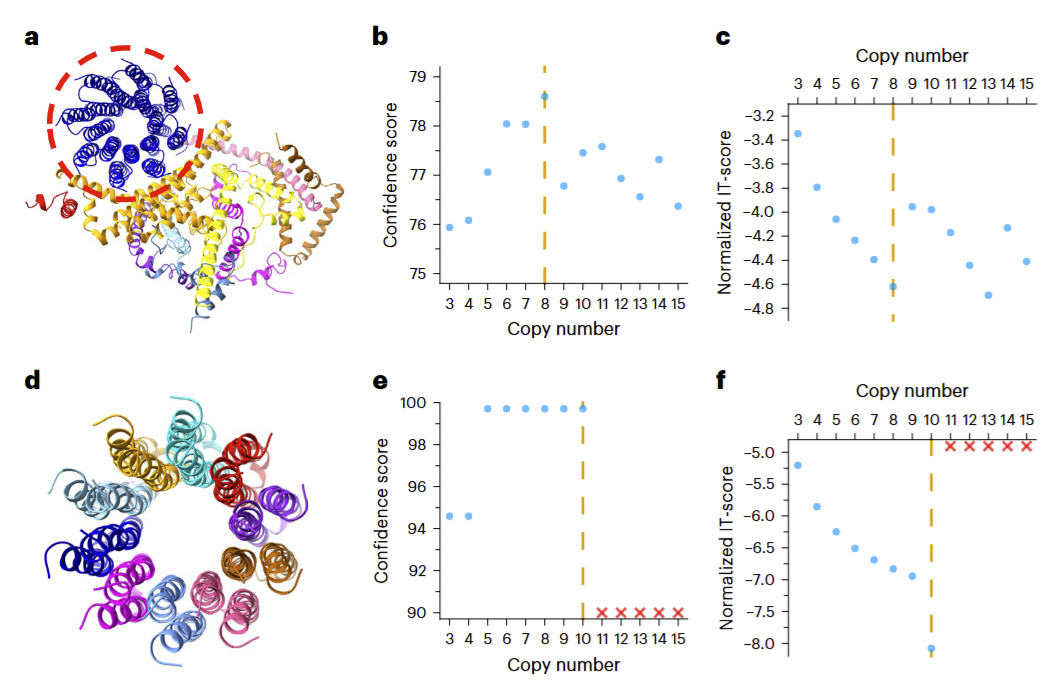
图6|HDOCK-Multimer通过组合组装与结构评分预测蛋白质复合物的亚基化学计量比。
讨论
本研究提出的HDOCK-Multimer通过融合传统分子对接与深度学习辅助组合组装,为大型蛋白质复合物结构预测提供了一种具有较高准确性和可扩展性的计算框架。与完全依赖端到端神经网络生成完整结构的方法不同,HDM利用AlphaFold预测局部亚复合物,再通过对接和组合搜索恢复复杂的整体组装关系,从而在一定程度上突破了显存容量和复合物规模限制。
研究的核心创新在于充分利用不同建模策略之间的互补性。组合组装能够高效利用局部界面信息,而多体对接可以修正错误的亚基排列并补充缺失的相互作用。对称性约束则进一步缩小了构象搜索空间,使复杂同源多聚体的结构预测更加准确。
此外,HDM能够通过组装评分推断亚基化学计量比,并在部分实验结构不完整的体系中恢复未解析区域,说明该框架不仅适用于标准结构预测基准,也具有辅助实验结构解析的潜力。然而,HDM仍存在一定局限。当前对称对接仅覆盖部分常见对称类型,尚未充分支持螺旋对称结构;模型评分主要基于两两亚基相互作用,难以完整反映复杂体系中的多体协同效应。此外,初始亚复合物的预测质量、结构域划分及候选模型排序仍可能限制最终准确性。
未来,通过引入AlphaFold预测的界面置信度、多体相互作用评分,以及交联质谱和冷冻电镜等实验约束,有望进一步提高大型蛋白质复合物结构预测的可靠性。
总体而言,HDOCK-Multimer证明,将深度学习局部结构预测与传统物理启发式组装策略相结合,能够有效突破大型蛋白质复合物结构预测中的规模与精度瓶颈,为复杂生物分子组装体的结构解析和功能机制研究提供了新的计算工具。
整理 | DrugOne团队
参考资料
Yao, X., Ya, Y., Li, H. et al. HDOCK-Multimer: improved structure prediction of large protein complexes by integrating docking and combinatorial assembly. Nat Comput Sci (2026).
https://doi.org/10.1038/s43588-026-01062-1
内容为【DrugOne】公众号原创|转载请注明来源