生生物药笔记 · 公众号
8月5日 07:32 · 阅读约 4 分钟
生物药笔记· 中国精选49分
小动物PK稀疏采样Sparse NCA参数计算教程
手把手教你小动物PK稀疏采样 Sparse NCA 参数计算(Phoenix WinNonlin)
发布于 2026/8/5 07:32:28(北京时间)
摘要
生物药笔记于2026年8月4日发布教程,详细讲解使用Phoenix WinNonlin进行小动物药代动力学(PK)稀疏采样(Sparse NCA)参数计算的方法。内容涵盖稀疏采样设计、NCA参数计算步骤、软件操作要点及注意事项,旨在帮助研究人员正确处理稀疏数据,获得可靠的PK参数。
AI 主编 · 推荐理由推荐理由
稀疏采样是小动物PK研究的常见难点,本教程提供实操指导,有助于注册申报中PK数据分析的规范性,建议相关研究人员学习并应用于实际项目。
正文
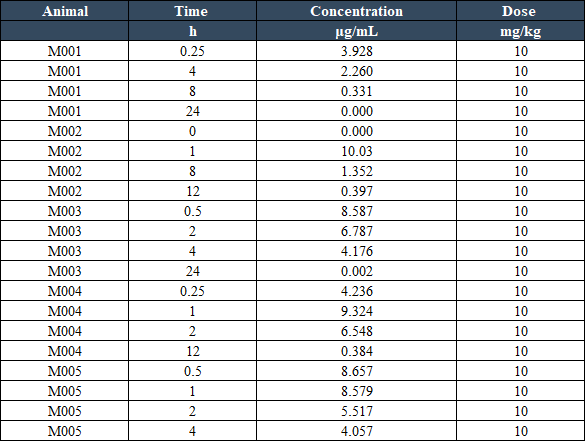
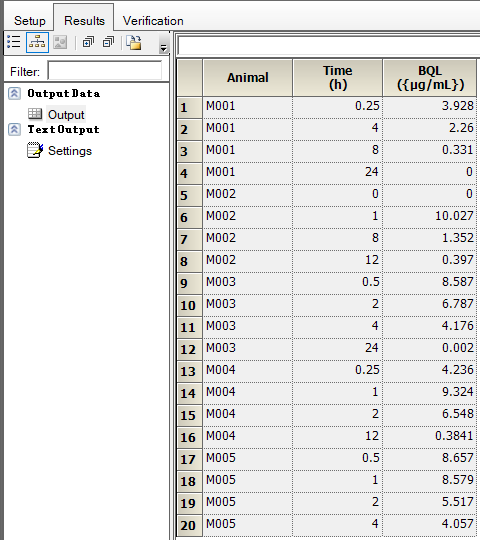
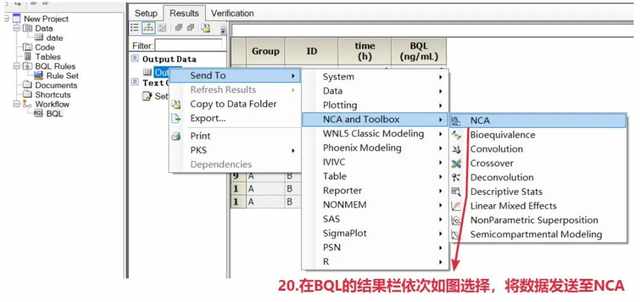
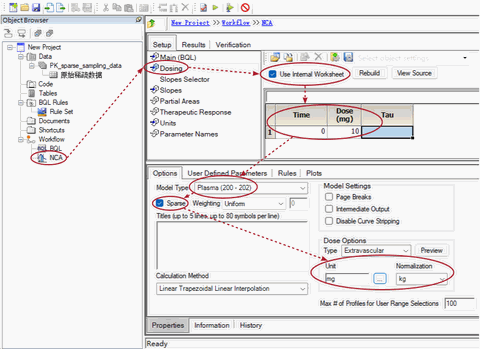
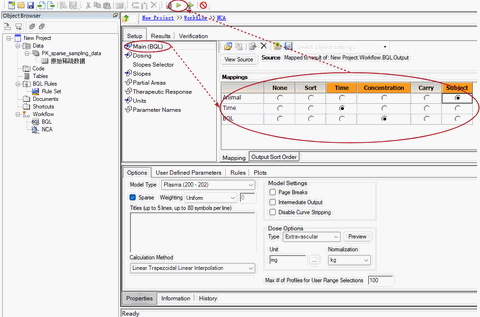
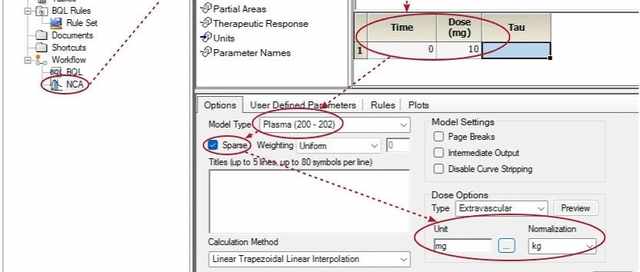
 我们先从稀疏采样讲起。在PK研究中,由于实验条件的限制,在使用小动物如小鼠时,往往只能采集有限的几个点的血样。比如一组5个小鼠,可能每个小鼠只能采集2~3个采血点。通常通过一组的小鼠,进行稀疏采样,来构成一条完整的药时曲线。这时,当多只动物贡献不同时间点的数据时,通常还要按照相同时间点的数据取平均。如果有需要,还可以将不同的组别进行合并,形成多条曲线进行比较。这种数据合并的前提是:所有参与合并的动物来自同一批次,同一性别,且体重接近。这是因为只有严格的控制了个体之间的差异,平均后的曲线才能反应该群踢的PK特征。选择BQL中的Results栏,选择Output Data下的Output表,右键在弹出栏内依次选择Send To -> NCA and Toolbox -> NCA,将数据发送至NCA。在NCA分析中,选择Dosing,勾选Use Internal Worksheet,设置time和Dose,使用Plasma模型,勾选Sparse,按照数据设置给药剂量Unit。在NCA分析中,选择Main,按照需求设置Mappings,点击运行。
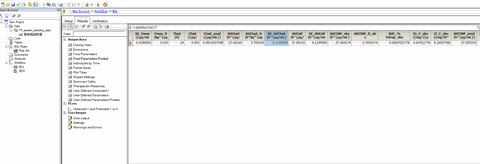
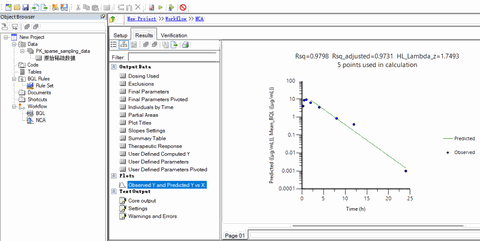
从结果看出,我们最开始提供的5只小鼠,已经被自动合并成一套并计算相应的PK参数。实际,在计算过程中,Phoenix WinNonlin已经自动将每个采血点进行了算数平均。当然,也可以在导入数据的时候,先进行平均,然后进行普通的NCA分析。当然,在计算的过程中,采用Sparse模式的话,可以有一些额外的参数进行参考,如:- SE_AUClast:不同个体AUClast的标准误;
- SE_AUCall:不同个体AUCall的标准误;
我们可以根据这些数据,判断不同个体之间的差异,尽量将其控制在合理的范围内,不要让合并的数据实际差异过大,影响判断。
现在,补充下开文朋友提到的BQL的问题。对于稀疏采样来说,BQL的处理更加敏感。这里给出我个人的观点,仅供大家参考。- 给药前(0h):理论上是空白,则设置成0则为合理;
- Tmax前,非0h:一般情况下不会出现BQL,虽然罕见但是也可能出现,这时候建议设置成0或者LOQ/2,理论上给药后浓度会上升;
- Tmax后,最后一个可定量的浓度之前出现BQL:这个点建议删除掉,理论上是有浓度的,只是因为检测或者其他原因未给出值,强行设置成0或者LOQ/2都会导致数据的误判;
- 最后一个可定量的浓度之后的BQL:理论上之后的点都是未定量出来,建议删除,也不要设置0或者LOQ/2,设置都会影响计算,导致低估过着高估。
当然,这是一般情况。实际还会遇到一些特殊情况,这时候建议做敏感性分析。即判断相对合理的2到3个处理方式后,对数据进行评判。无论最后采用哪种方式,也不要对数据进行区别对待,需要对所有数据采用统一规则。
参考:1. Sparse sampling (pre-clinical) data. certara