RFD4-Proteina:英伟达联手华盛顿大学,开启AI蛋白质设计新篇章
摘要
2026年10月21日,英伟达(NVIDIA)在德国柏林举行的GTC大会上宣布,与华盛顿大学医学院蛋白质设计研究所(Institute for Protein Design,IPD)合作推出全新开放式
五维评分
正文
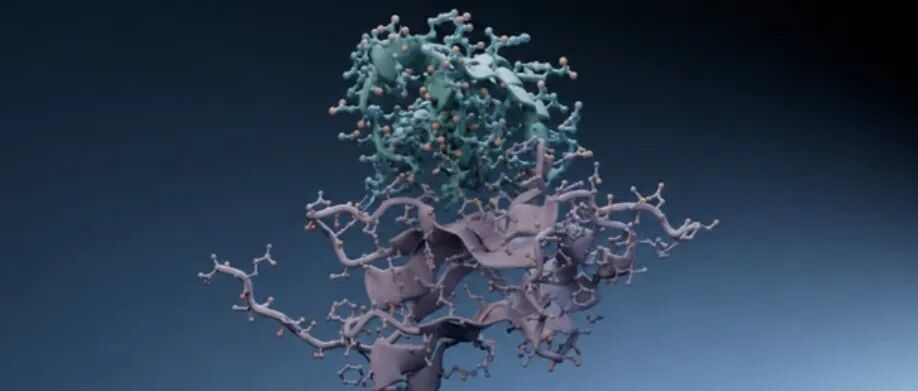
2026年10月21日,英伟达(NVIDIA)在德国柏林举行的GTC大会上宣布,与华盛顿大学医学院蛋白质设计研究所(Institute for Protein Design,IPD)合作推出全新开放式生物分子生成模型 RFD4-Proteina,进一步推动人工智能在蛋白质设计、药物发现和生物医学研究中的应用。此次发布不仅展示了AI驱动分子设计的新进展,也体现了英伟达在生命科学领域的整体布局。一方面,RFD4-Proteina将可编程蛋白质生成与推理时搜索相结合,使研究人员能够根据分子结构、化学约束和功能目标生成并优化候选蛋白质;另一方面,英伟达正与西门子医疗合作,通过智能体协同规划、患者特异性模拟和机器人控制推动自适应放射治疗发展。同时,Automata、Benchling、Boltz、Danaher等企业也在利用NVIDIA BioNeMo开放平台开发科研智能体,连接药物设计、自动化实验室与生物学发现,加快从科学假设到实验验证的研究进程。
生物分子设计的核心在于寻找满足特定化学相容性、空间几何约束及功能要求的原子和分子排列方式。然而,现有深度学习模型所能解决的问题复杂程度,不仅取决于训练过程中覆盖的分子化学空间,还受到模型探索这一空间能力的限制。为解决上述问题,研究人员提出RFD4-Proteina,一种基于物理信息引导的统一化学与构象潜在空间、并融合内部和外部推理机制的生物分子生成模型。该模型通过统一表示天然与修饰氨基酸、糖类及核酸结构,并引入力场能量监督增强生成构象的物理合理性。在此基础上,模型通过循环精修动态分配计算资源,并利用几何约束、能量评价等目标引导生成过程中的搜索。在多个计算基准中,RFD4-Proteina同时提升了设计成功率和生成吞吐量,并且无需额外训练,即可完成侧链构象优化、固定骨架序列设计、构象采样和结构精修等任务。进一步的实验验证表明,该模型能够设计具有较高亲和力和选择性的蛋白质结合体,识别特定翻译后修饰和糖基化状态,并生成能够催化化学键断裂与形成的人工酶。这些结果表明,将多样化分子化学表示、物理约束和可扩展推理机制整合至生成模型,有望拓展人工智能驱动生物分子设计的应用范围。
近年来,以RFdiffusion、RFdiffusionAA和RFD3为代表的生成式蛋白质设计方法,逐步实现了从蛋白质骨架生成到蛋白质与其他分子相互作用结构的联合设计。然而,面对包含非天然氨基酸、糖基化修饰、核酸、金属离子及复杂催化中心的任务时,现有模型仍面临两个重要挑战。
首先,不同分子类型通常具有不同的表示方式和几何约束。蛋白质骨架、侧链、小分子及核酸的结构特征难以直接统一,限制了模型对复杂生物分子体系的建模能力。其次,传统生成方法通常需要产生大量候选结构,再利用独立的预测或能量评价工具进行筛选。这种生成与评估相对分离的流程不仅增加了计算成本,也难以在生成过程中及时利用评价结果改善设计方向。
RFD4-Proteina的研究思路是将上述问题转化为一个统一的潜在空间探索问题,使模型既能够表示不同类型的分子,又能够利用分子内部的物理约束和外部评价信息进行迭代优化。其主要突破不只是生成更复杂的分子结构,而是将推理能力引入生物分子生成过程,使模型能够在设计过程中分配计算资源、判断候选结构质量,并逐步探索符合功能要求的构象。
RFD4-Proteina:从蛋白质生成走向潜在空间推理
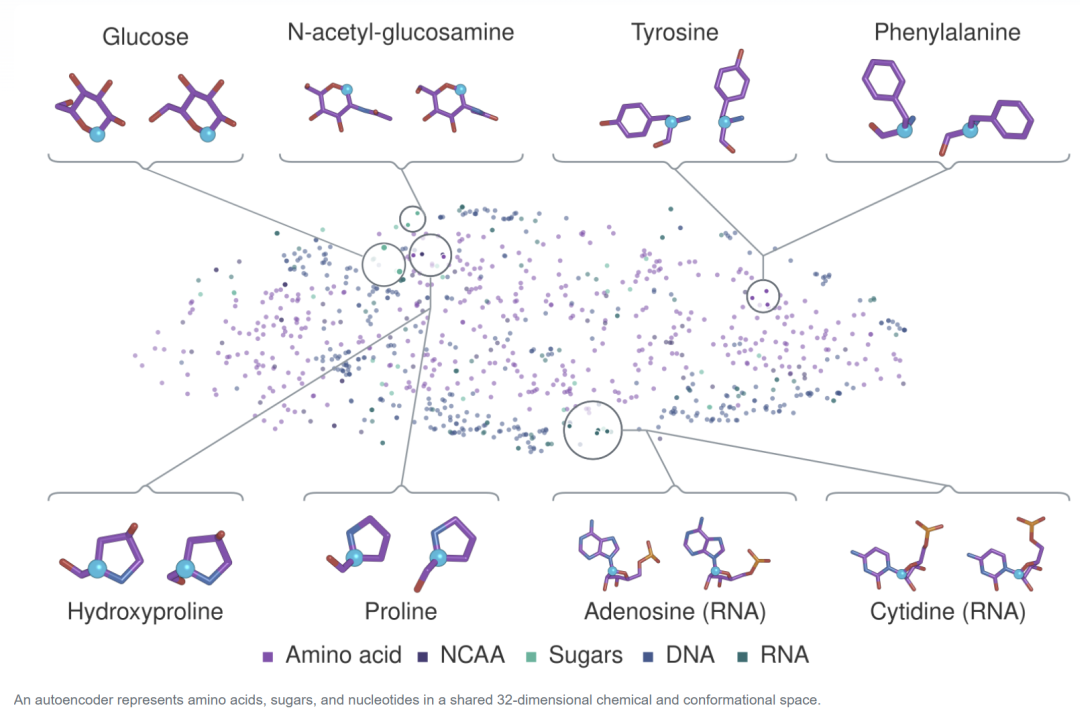
RFD4-Proteina采用统一的化学与构象潜在空间表示生物分子体系。研究人员利用自编码器,将标准氨基酸、修饰氨基酸、糖类和核苷酸的局部化学与构象信息编码至共享的32维潜在空间,并结合力场能量监督,使模型学习不同分子组分的结构特征及其物理约束。在生成阶段,模型采用流匹配方法,从随机噪声出发,逐步生成分子三维结构和对应的潜在表示,再通过解码器恢复分子序列与原子坐标。与分别处理蛋白质序列、骨架和侧链的设计流程相比,这一框架能够在统一过程中协调分子组成、空间构象及相互作用。
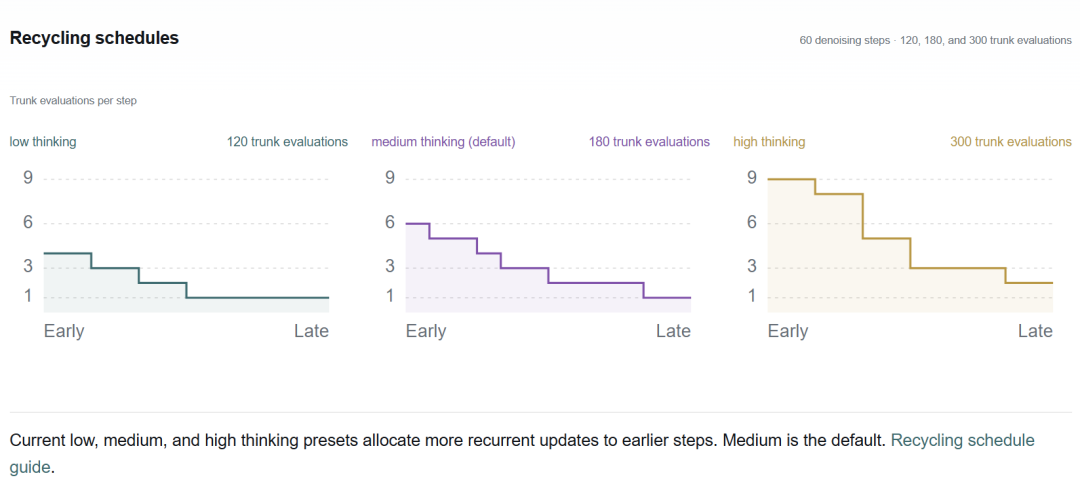
RFD4-Proteina进一步引入两种互补的推理机制。内部推理(intrinsic reasoning)通过循环精修实现模型计算资源的动态分配。模型在生成过程中重复执行结构更新,使中间构象在进入后续步骤之前得到进一步优化。根据官网披露的推理设置,模型可通过增加循环次数实现不同程度的精修,其中低、中、高推理模式分别对应不同的主干网络评估预算。增加循环精修计算量能够改善候选质量,但也会增加推理成本。
外部推理则通过评分引导搜索,将生物分子的结构和功能要求直接纳入候选生成过程。研究人员在不同生成阶段使用不同的评价标准:在早期利用界面面积判断候选结构是否形成合理的接触关系,在中期根据氢键等相互作用进行筛选,在后期进一步结合AlphaFold3预测置信度评价整体设计。这种逐阶段搜索机制能够提前淘汰不符合要求的设计分支,将后续计算资源集中于更有潜力的候选结构。
这一设计使RFD4-Proteina具备了区别于常规生成模型的特征,即能够在统一分子空间中进行构象探索,并利用额外的推理计算改善设计质量。对于涉及多个分子组分、复杂相互作用和严格几何约束的任务,这种方法为提高生成效率与结构可靠性提供了新的技术途径。
RFD4-Proteina在多种计算设计任务中取得性能提升
为评估RFD4-Proteina的通用设计能力,研究人员构建了涵盖蛋白质结合、小分子结合、酶活性位点支架设计和DNA结合的四类计算基准,并与BindCraft、RFD3等现有方法进行比较。研究采用AlphaFold3对生成序列进行重新折叠,评价预测结构与预期设计之间的一致性,同时结合任务特定的结构指标判断候选是否通过筛选。为避免大量重复生成相似结构影响成功率,研究人员进一步采用结构聚类,统计具有不同结构特征的成功设计。
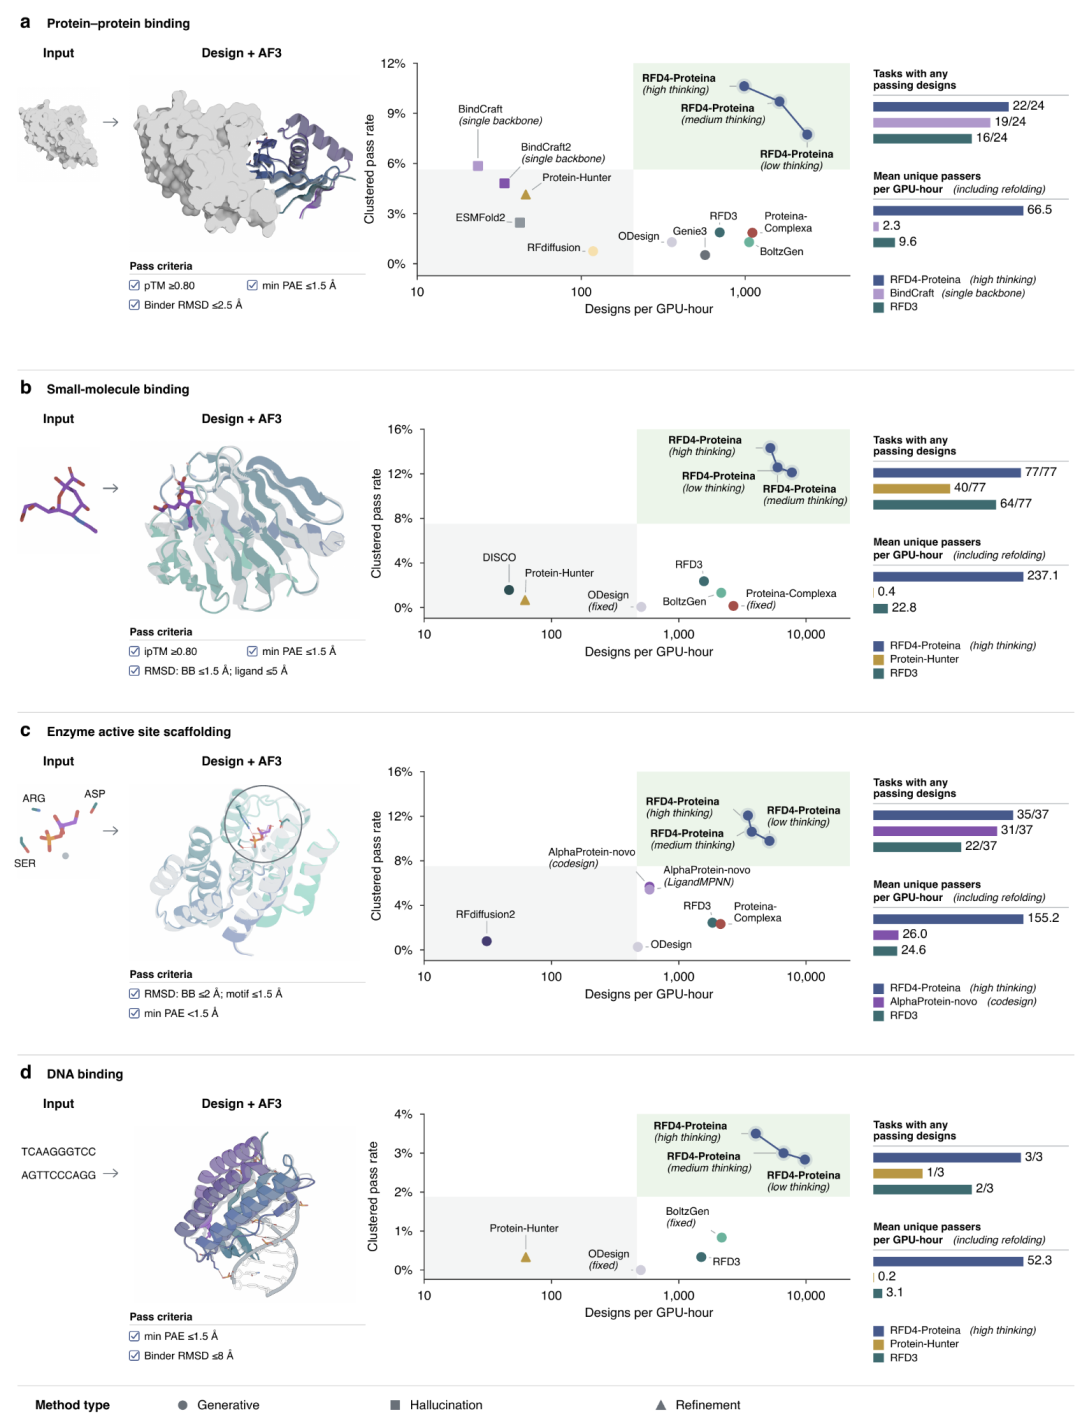
在蛋白质结合体设计任务中,RFD4-Proteina在24个靶标上的聚类通过率达到10.6%,高于BindCraft的5.9%,而生成吞吐量达到后者的42倍。在小分子结合体设计任务中,模型的聚类通过率达到14.3%,明显高于最佳对照模型的2.4%。对于酶活性位点支架设计,RFD4-Proteina的通过率为12.1%,对照方法为5.7%;在DNA结合设计中,相应数值分别为3.5%和0.8%。这些结果表明,RFD4-Proteina在多个不同分子体系中兼顾了设计质量和生成效率。
除了整体通过率,模型还表现出更广泛的任务覆盖能力。在24个蛋白质结合靶标中,RFD4-Proteina成功覆盖22个;在77个小分子靶标中覆盖全部77个;在37个酶支架任务中覆盖35个;而三个DNA结合靶标均获得通过计算筛选的候选结构。进一步分析发现,增加推理计算量能够提高模型的设计表现。例如,在蛋白质结合任务中,低推理模式下的聚类通过率为7.7%,高推理模式提高至10.6%,但生成吞吐量也从每GPU小时2,388个下降至986个。这一结果说明,模型能够通过推理预算在生成效率与设计质量之间进行调节,而无需重新训练不同复杂程度的模型。
值得注意的是,同一个RFD4-Proteina模型还能够在无需额外训练的情况下完成侧链构象优化、固定骨架序列设计、构象采样和结构精修等任务,并达到或超过相关专用方法的性能。这表明,统一化学与构象潜在空间不仅可以服务于从头生成任务,也能够作为不同分子设计问题之间共享的结构表示基础。
实验验证高亲和力与高选择性蛋白质结合体的设计能力
为进一步验证模型生成结构的实际功能,研究人员开展了多种具有不同生物学要求的蛋白质结合体设计实验,包括钙离子依赖性识别、肽–MHC复合物识别、天然无序肽结合以及Trk受体亚型和物种选择性识别。这些任务不仅要求设计蛋白具有较高的结合亲和力,还要求其能够区分具有相似序列或结构特征的非目标分子。
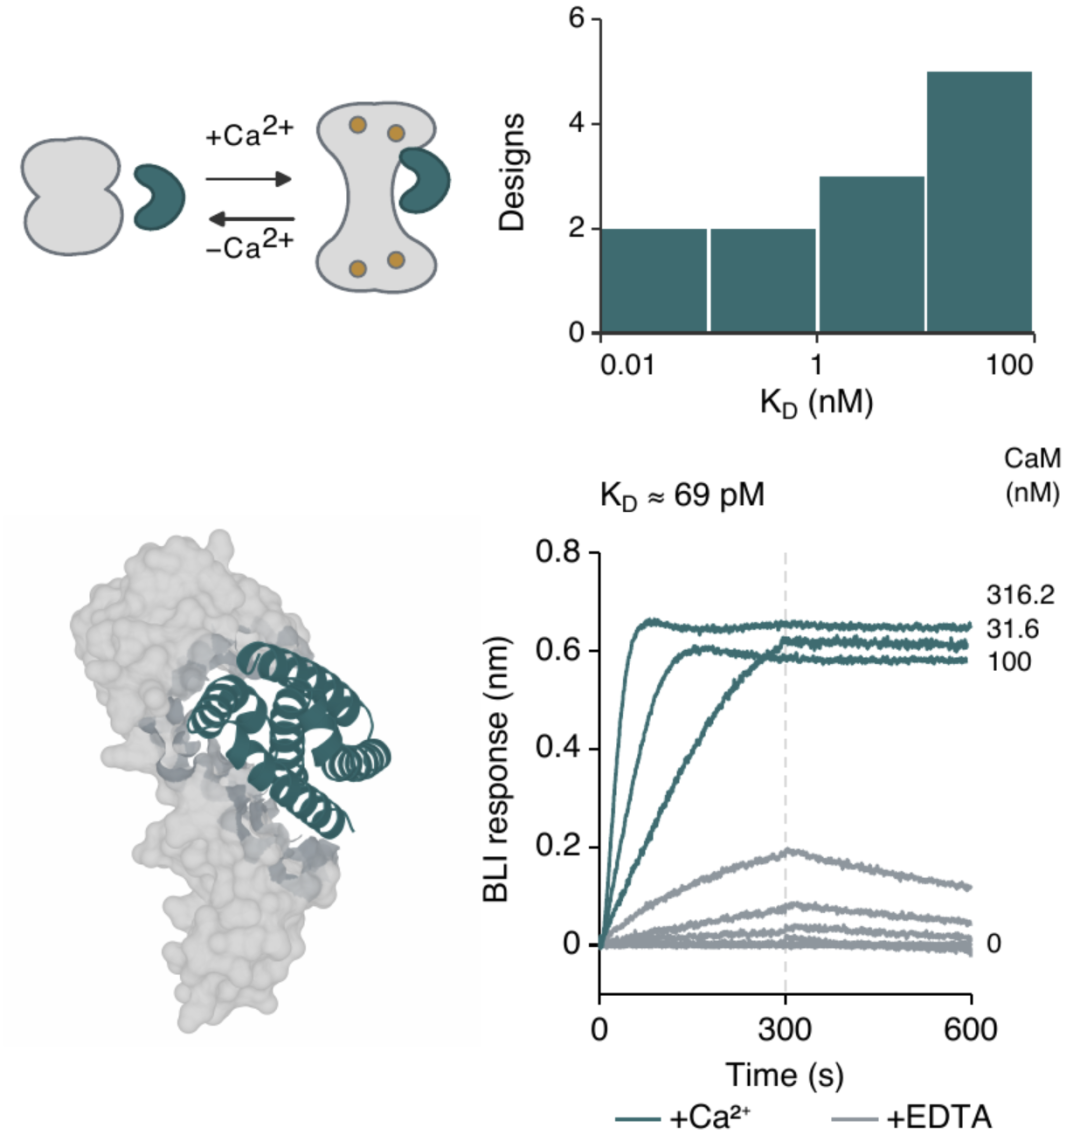
在钙调蛋白结合体设计中,研究人员利用钙调蛋白结合钙离子后发生构象变化的特点,设计能够优先识别其钙离子结合状态的蛋白质。18个实验候选中有12个表现出低于1 μM的表观解离常数,且在缺乏钙离子的条件下未检测到结合信号。部分候选的表观结合亲和力达到皮摩尔水平,说明RFD4-Proteina能够将靶标特定构象状态作为设计条件,实现依赖分子状态的蛋白质识别。
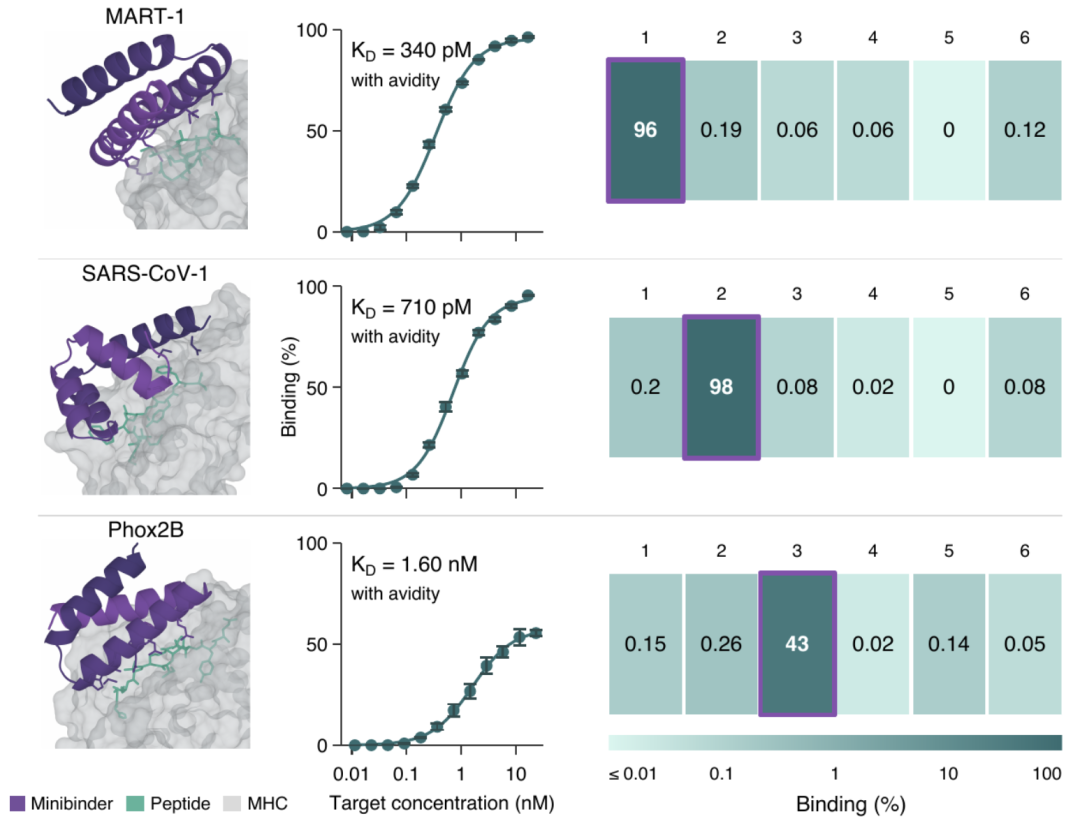
在肽–MHC复合物结合体设计中,研究人员分别针对MART-1、SARS-CoV-1和Phox2B相关复合物开展设计。三个代表性候选的表观半最大结合浓度分别达到340 pM、710 pM和1.60 nM,并且均表现出超过100倍的靶标偏好性。特别是在Phox2B和SARS-CoV-1相关实验中,部分非目标肽与目标肽仅相差一个或两个氨基酸残基,但模型设计的结合体仍能够有效区分这些相似序列。这说明模型不仅能够优化整体蛋白质结合界面,还能够利用局部序列差异构建具有选择性的分子识别结构。
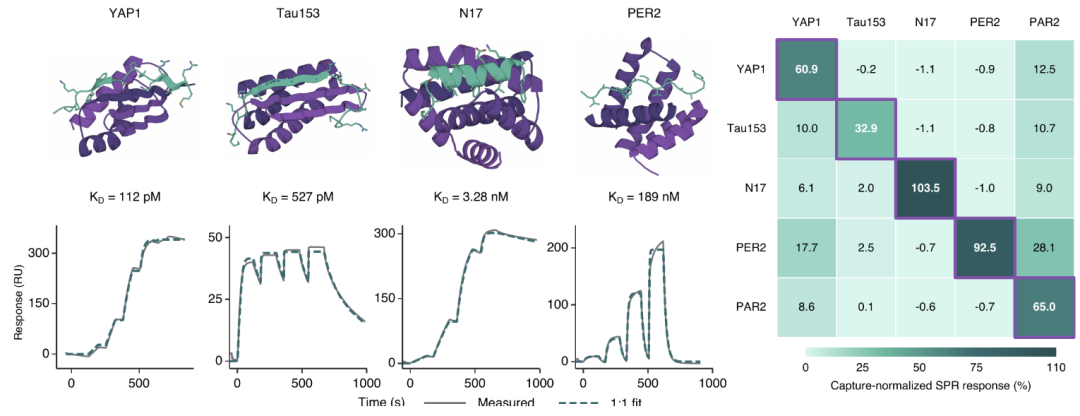
研究人员进一步将设计任务拓展至天然无序肽。由于这类肽段缺乏稳定的单一三维构象,传统基于固定靶标结构的方法难以直接应用。研究团队选择八种天然无序肽作为设计目标,其中包括结合时倾向于形成二级结构的肽段,以及缺乏明显结构形成倾向的肽段。实验结果显示,在五种已知具有结合诱导折叠倾向的肽段中,有四种获得较强结合体;在另外三种肽段中,也有两种获得有效候选。针对YAP1和Tau肽段设计的代表性结合体,其SPR测定亲和力分别达到112 pM和527 pM。进一步的交叉结合实验表明,设计蛋白总体上更倾向于识别其预定靶标,体现了模型处理柔性靶标和动态构象的能力。
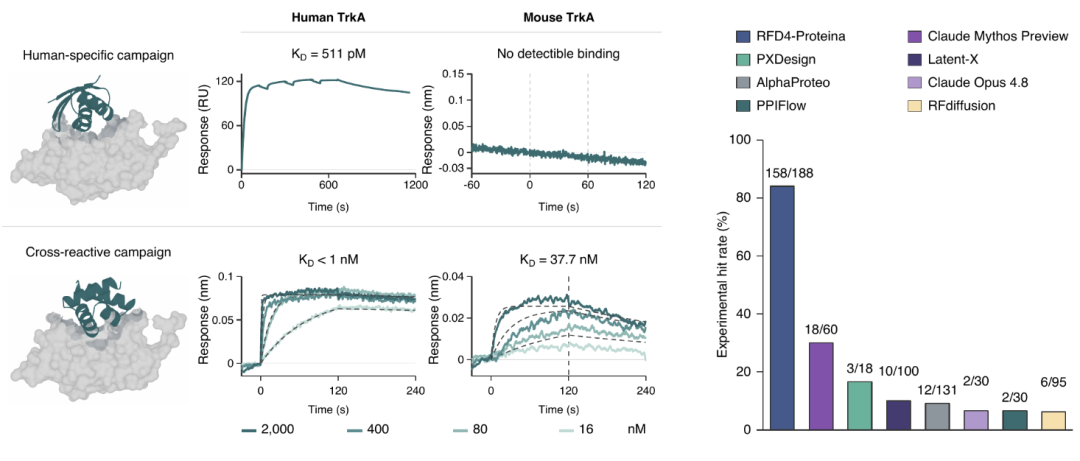
在Trk受体设计中,研究人员同时考察了物种选择性和同源受体之间的识别差异。针对人TrkA设计的部分候选能够有效识别人源蛋白,而不结合小鼠TrkA及人TrkB、TrkC。另有18个候选能够同时结合人和小鼠TrkA,但不明显识别其他Trk家族成员。在不施加额外选择性约束的人TrkA设计任务中,188个候选中有158个达到亚微摩尔级亲和力,实验成功率约为84%。这些结果显示,RFD4-Proteina不仅适用于构建高亲和力蛋白质结合界面,也能够通过设计约束调控结合体的选择性与交叉反应特征。
从糖基化调控到磷酸化位点识别的复杂分子设计
蛋白质翻译后修饰在细胞信号传递、免疫识别和分子相互作用中发挥重要作用,但糖基化和磷酸化等修饰引入了额外的化学组成、柔性结构和局部相互作用,使其成为蛋白质设计中的复杂任务。RFD4-Proteina通过统一的分子表示,能够直接将糖链和修饰氨基酸纳入设计体系,从而根据特定修饰状态构建相应的结合或空间遮蔽结构。
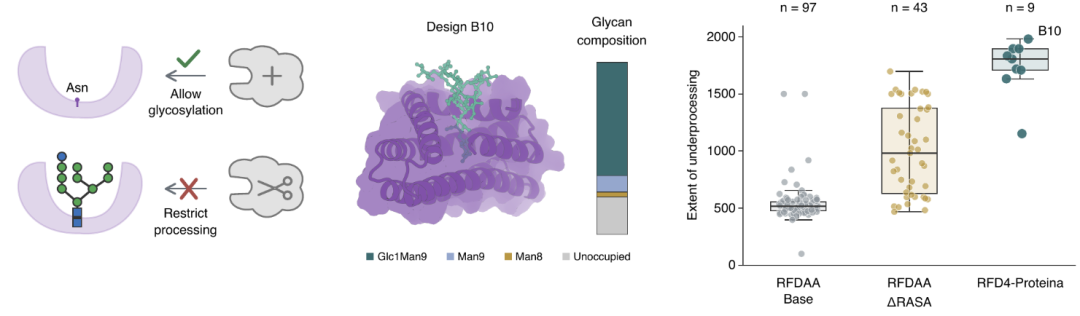
在糖基化调控任务中,研究人员尝试设计能够包围N-连接糖链核心区域、同时保留末端甘露糖暴露的蛋白质结构。这种空间遮蔽策略能够阻碍内质网和高尔基体中糖链加工酶对部分糖基结构的进一步修饰,从而促进未充分加工的高甘露糖型糖链保留。与此前主要获得Man5至Man8糖链的设计方法相比,RFD4-Proteina能够生成有利于保留Man9及Glc1Man9等糖链状态的蛋白质。实验中,九个设计有八个在已占据的糖基化位点上表现出超过90%的寡甘露糖比例,而且所需蛋白质结构尺寸更小。这表明模型能够通过对糖链局部空间环境的精细设计调控糖基化加工过程,为糖蛋白工程和疫苗相关研究提供新的设计途径。
在磷酸化修饰识别任务中,研究人员针对组蛋白H3尾部的三个磷酸化位点pS10、pT11和pS28设计结合体。实验结果显示,三个位点均获得磷酸化依赖性结合候选。其中,针对pS10和pT11的代表性结合体在酵母展示实验中的表观响应中点分别为179 nM和133 nM。进一步分析表明,部分设计能够有效区分相邻残基的磷酸化状态,避免仅凭磷酸基团存在与否产生非特异性识别。由于这些数值来自酵母展示滴定曲线,不能直接等同于溶液中的平衡结合亲和力,但仍支持模型具有识别不同翻译后修饰状态的能力。
这两类实验说明,RFD4-Proteina的统一分子表示能够将蛋白质设计拓展到包含多样化化学修饰的生物学体系,而不仅局限于由标准氨基酸构成的蛋白质骨架与界面。
从头设计高效人工酶,实现化学键断裂与形成反应
酶设计是检验生物分子生成模型能力的重要任务。与一般蛋白质结合体设计不同,酶催化不仅要求底物能够稳定结合,还要求多个催化残基、金属离子及底物反应基团之间满足严格的空间几何关系。在催化反应过程中,底物和活性位点还可能发生构象变化,因此,仅获得稳定的蛋白质结构并不足以保证催化活性。研究人员利用RFD4-Proteina开展磷酸三酯酶和酰胺键连接酶设计,分别验证模型催化化学键断裂和形成的能力。
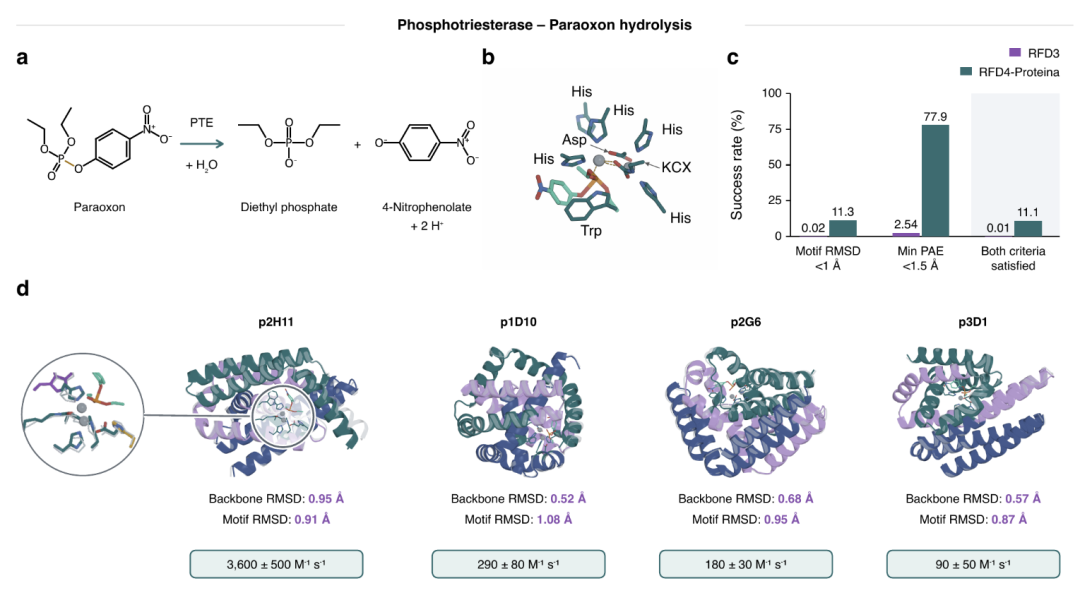
在磷酸三酯酶设计中,研究人员选择能够催化有机磷化合物对氧磷(paraoxon)水解的双金属活性中心作为研究对象。此前基于RFD3的方法已经能够围绕两个金属离子构建包含六个关键残基的人工催化中心,但其催化效率仍然较低。为进一步增强底物与催化中心之间的相互作用,研究团队将活性位点扩展至八个关键残基,这也对模型精确控制催化残基空间位置的能力提出了更高要求。
计算筛选结果显示,在1,000个RFD4-Proteina生成设计中,有111个通过预设结构评价,而RFD3在10,000个候选中仅有1个通过相应筛选。随后,研究人员对288个RFD4-Proteina候选开展实验检测,其中89个表现出可检测的催化活性,覆盖47个蛋白质支架家族中的25个。进一步的酶动力学表征表明,表现最佳的人工酶催化效率达到3,600 ± 500 M⁻¹ s⁻¹,催化周转数达到0.9 s⁻¹,相对于无催化剂条件下的水解反应实现约1,500万倍的速率提升。六个经过详细表征的设计,其催化效率均比此前的人工磷酸三酯酶提高约10至1,000倍(图6a–g)。
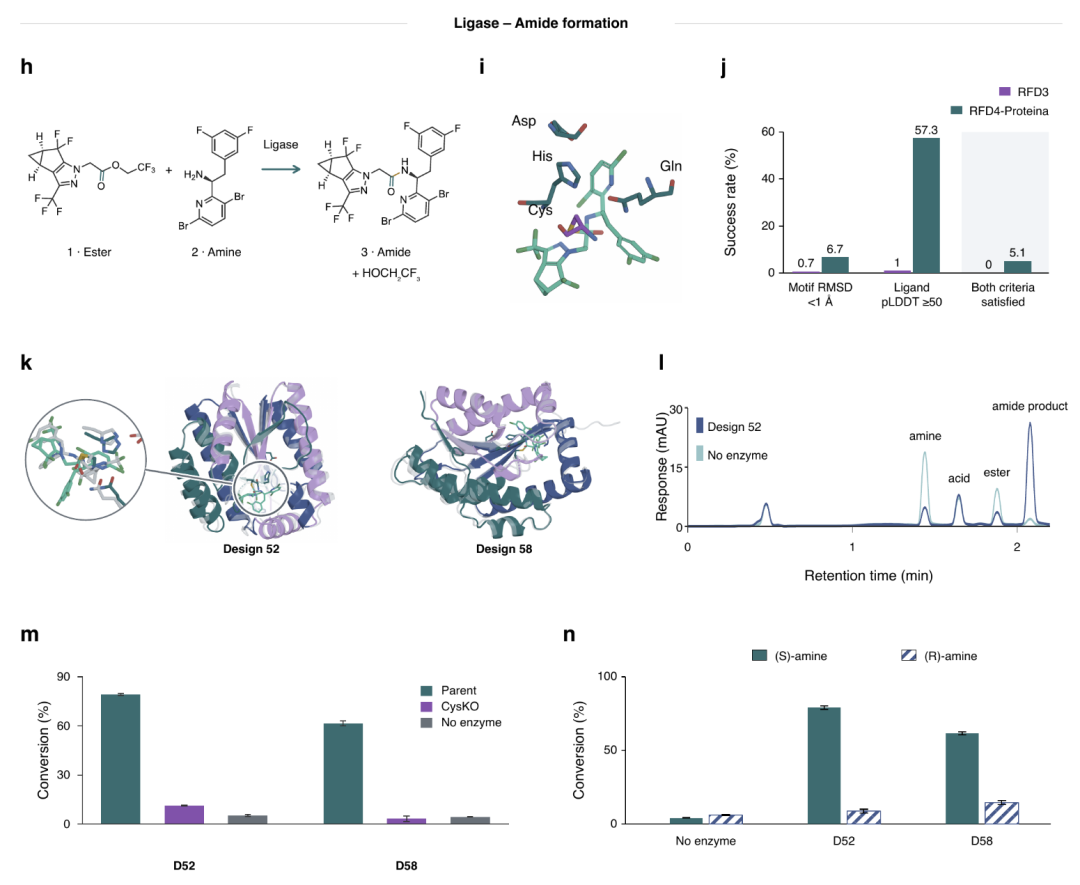
研究人员进一步探索RFD4-Proteina在药物合成中的应用,以抗HIV药物来那卡帕韦的酰胺键形成步骤为目标,设计能够催化活化酯与手性胺发生反应的人工连接酶。由于该反应需要在具有空间位阻的手性底物之间形成酰胺键,同时抑制活化酯水解,因此对活性位点几何排列和底物立体选择性具有较高要求。
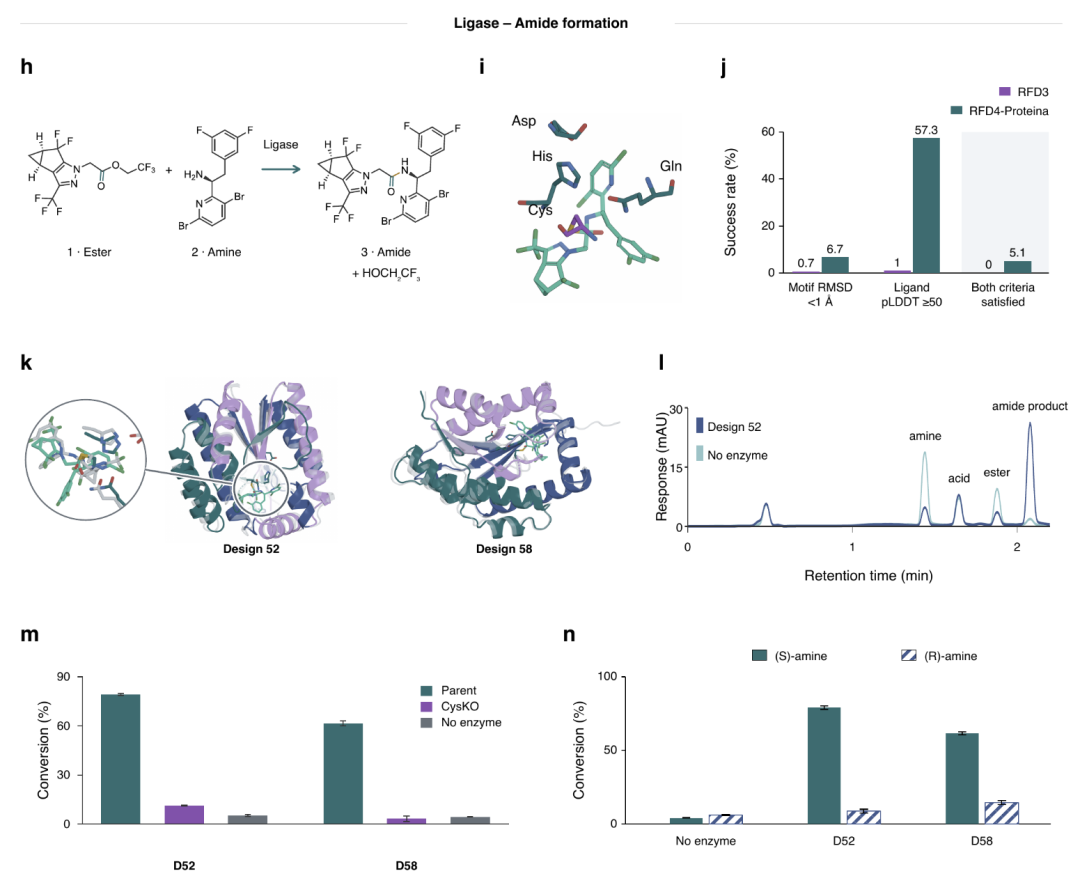
研究团队以半胱氨酸蛋白酶催化三联体为基础构建催化中心,并结合多状态AlphaFold3结构筛选,优先保留能够促进目标氨解反应的候选。在67个实验设计中,有4个表现出高于背景水平的酰胺生成能力,而此前RFD3设计的72个候选均未获得相应活性。表现最佳的Design 52能够使79.0%的(S)-构型胺转化为目标酰胺,而(R)-构型胺的转化率仅为8.8%,显示出明显的立体选择性。另一候选Design 58对两种构型底物的转化率分别为61.7%和14.6%。催化半胱氨酸突变实验进一步支持该残基对反应活性的重要作用(图6h–n)。
这一研究提供了从头设计人工酶参与药物活性成分合成步骤的概念验证。尽管目前仍属于实验室阶段,距离实际工业生产中的催化效率、稳定性和工艺适配要求尚有距离,但这一结果表明,生成式模型有望从蛋白质结构与结合界面设计进一步拓展至具有明确化学反应目标的酶催化设计。
讨论与展望
RFD4-Proteina的研究价值在于,将化学多样性、分子构象探索和推理时优化整合到同一个生物分子生成框架中。统一的化学与构象潜在空间使模型能够处理多种分子组分,而循环精修和评分引导搜索则为复杂设计任务提供了更灵活的优化机制。计算基准和湿实验结果表明,这种方法不仅能够提高常规蛋白质结合体设计的效率,还能够拓展至翻译后修饰识别、柔性靶标结合和酶催化等任务。
不过,模型仍然依赖计算评价函数对候选结构进行筛选,而预测结构的可靠性与实际实验功能之间并不完全一致。增加推理计算量虽然可以改善部分设计结果,但也伴随着计算成本上升。此外,针对复杂催化反应的人工酶,其催化效率、稳定性和实际应用价值仍需进一步优化与验证。
总体而言,RFD4-Proteina展示了生物分子设计从大规模结构生成向物理约束引导、目标驱动和推理时搜索相结合的发展方向,为未来更加通用和高效的AI蛋白质设计模型提供了新的研究思路。
编译整理:王建民
参考资料
https://nvidianews.nvidia.com/news/healthcare-and-life-sciences-leaders-build-on-nvidia-to-advance-drug-discovery-and-expand-patient-care
https://rfd4-proteina.org
https://github.com/RosettaCommons/RFD4-Proteina
https://huggingface.co/nvidia/RFD4-Proteina