南方医团队构建脂肪肝预测模型,可提前16年预警
提前16年预测!南方医团队用5个血浆蛋白构建脂肪肝病预测模型,这是这么做到的?
摘要
南方医科大学团队利用5个血浆蛋白构建了脂肪肝病预测模型,该模型可提前16年预测个体患病风险。研究基于大规模队列数据,通过蛋白组学分析筛选出关键生物标志物,并验证了模型的准确性和稳定性。相关成果已发表,为脂肪肝的早期筛查和干预提供了新工具。
AI 主编 · 推荐理由推荐理由
该模型为药企在代谢性疾病早期诊断和药物研发靶点选择上提供新思路,建议关注相关生物标志物在临床试验中的应用潜力。
五维评分
正文
源自风暴统计网:一键统计分析与绘图的网站
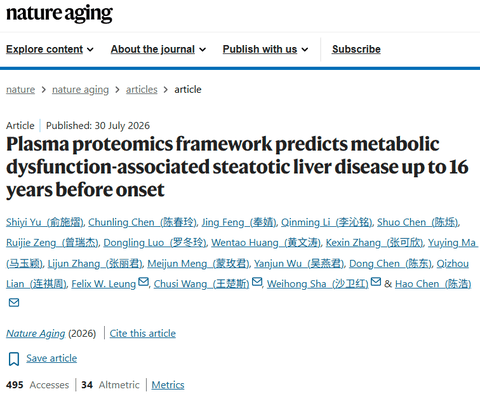
近期,顶级期刊《Nature Aging》(医学一区top,IF=25.0)发表了一项多国参与的大规模蛋白质组学研究。
研究团队利用超五万人、最长16.6年随访的多国蛋白质组学数据,从2737个血浆蛋白中锁定5个关键蛋白,能够在MASLD临床发病前最长16年实现有效预测。
我们来看看这项研究到底做了什么!
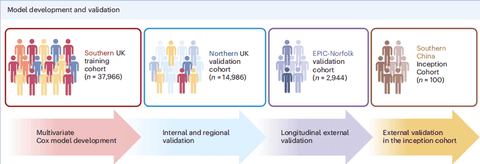
研究者将UKB的招募中心按纬度从南到北排序,依次分配到南方队列,其余归入北方队列,直到两组人数比例达到约70:30。
此外还用了EPIC-Norfolk队列(n=2944,年龄40-79岁)和中国南方初发队列SCIC(n=100)作为独立外部验证。
√特征筛选
研究团队首先用Olink Explore 3072平台检测了2,737种血浆蛋白。
先用多因素Cox回归校正年龄、性别、BMI、吸烟饮酒、高血压糖尿病等13项临床变量,筛出323个与未来MASLD显著相关的蛋白(Bonferroni校正,P<0.05)。
再对这323个蛋白进行顺序前向选择,每一步用DeLong检验比较AUC是否有显著提升,新增蛋白不改善模型性能就停止。
最终锁定五个蛋白:FUOM、ACY1、GGT1、CDHR2和KRT18。
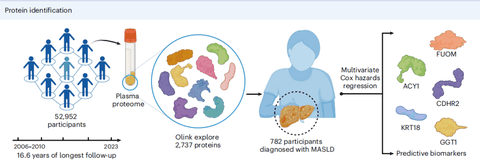
这五个蛋白中,GGT1和KRT18此前已被发现与肝脏损伤有关,但作为超长期预测因子来用还是第一次。
√预测模型的构建与验证
为了全面评估蛋白质标志物的预测价值,研究者构建了多个层次的模型,即
单个蛋白分别建模、
五个蛋白联合建模、
五个蛋白加13项临床因素联合建模。
另设30个蛋白扩展模型作为敏感性分析,用于检验五蛋白组合是否已接近最优性能。
模型训练在Southern UK队列完成,内部验证采用Bootstrap 1000次重抽样。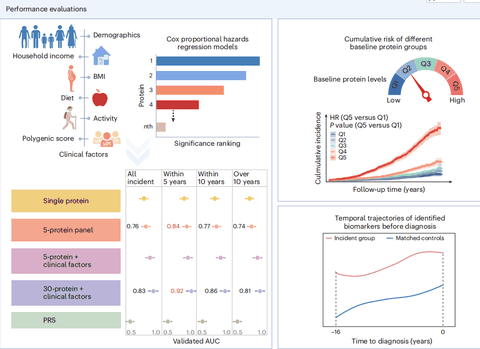
如果PRS也能达到相近的预测效果,说明蛋白标志物没有特殊价值,直接用基因检测就可以了。 结果显示,PRS的AUC仅为0.511~0.526,基本等同于随机猜测,而五蛋白模型在所有时间窗口的AUC均超过0.74。
研究结果显示,五个蛋白加临床因素的融合模型在所有时间窗口表现最优。
5年AUC为0.904,10年AUC为0.848,超过10年AUC为0.799。
同时,只用五个蛋白构建的模型,5年预测AUC也达到0.838。
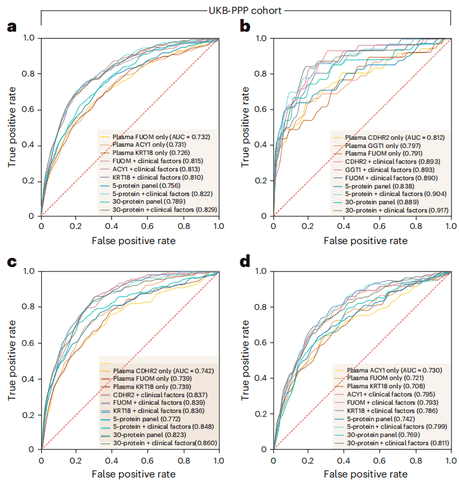
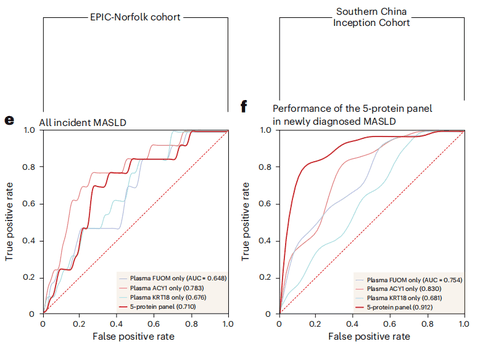
模型性能外部验证结果同样稳健。
在EPIC-Norfolk队列中,16.6年长期预测AUC为0.710。
在中国南方队列中,五个蛋白模型AUC达到0.912,说明模型在亚洲人群中同样适用甚至表现更好。
时间轨迹分析显示,后来确诊MASLD的个体,这五个蛋白的水平从发病前16年开始就持续高于未发病的对照组。
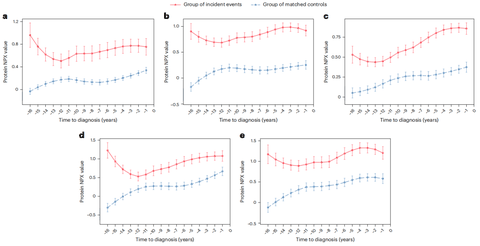
在最年轻和最年长的年龄组中都能观察到同样趋势,说明这种蛋白信号并非年龄因素所致。
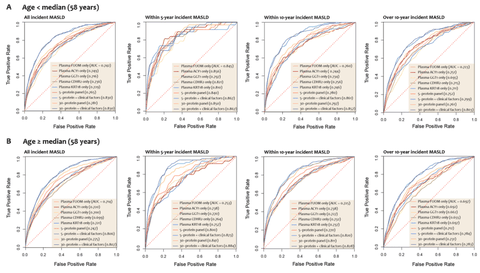
研究者用Youden指数确定最佳截断值0.358,将人群分为高风险和低风险两组。结果显示,高风险组发生MASLD的风险是低风险组的5.67倍。
综上所述,该研究基于四国超五万人的队列数据,利用Olink蛋白质组学平台筛选出五个关键蛋白,构建了可提前16年预测MASLD发病风险的预测模型,并在三个独立外部队列中验证了模型的稳健性和跨人群适用性。
老郑小评
这篇文章的技术路线非常完整,从关联筛选到建模筛选,从单蛋白到多蛋白组合,从内部验证到三层外部验证,从模型解释到简化落地,每一步都做得很扎实。
其中最值得说的,是它的思路。从2737个蛋白筛到5个,最后用这5个蛋白建出来的模型,5年AUC达到了0.838。
虽然加了临床因素AUC能到0.904,但单用五个蛋白的模型性能本身就已经很不错了。
很多预测模型研究动不动就几十个变量,回头临床根本用不了。这篇文章的五个蛋白,用ELISA就能测,一管血的事,基层医院也能做。所
以说,做预测模型不一定是变量越多越好,能用最少的变量解决问题才是本事。
另外就是16年这个预测窗口,确实够长。蛋白水平的差异在发病前16年就已经出现了,给临床留了非常充裕的干预时间。
关于郑老师团队及公众号
学统计就找郑老师团队,我们有全面的医学统计课程!
1.医院临床数据分析课程
临床试验(RCT)研究设计与数据分析;临床预测模型和基于R语言/Python的机器学习方法在临床预测模型中的应用(附赠全套代码);医院回顾性数据与真实世界临床研究,涵盖目标模拟试验(模拟RCT)、缺失数据填补下真实世界研究、倾向性评分方法(包括倾向性得分匹配、逆概率加权,重叠加权)等
2.纵向数据分析课程
3.公共数据库挖掘与分析课程
NHANES(美国国家健康和营养检查)公共数据库、GBD(全球疾病负担)公共数据库、七大老年健康数据库挖掘与分析课程;孟德尔随机化方法快速发表SCI初级班、高级班以及进阶攻略:整合网络药理学&单细胞测序
4.其他课程
需以上统计课程,请联系郑老师团队(微信:aq566665)