INSPIRE围手术期数据库数据整理思路分享
INSPIRE围手术期数据库如何整理数据,看看我们的思路
摘要
2026年7月14日,医学论文与统计分析公众号发布文章,介绍INSPIRE围手术期数据库的数据整理思路。文章可能涉及数据清洗、标准化、变量定义等流程,旨在为围手术期研究提供数据管理参考。具体内容未提供摘要,但标题表明其聚焦于数据库整理方法。
AI 主编 · 推荐理由推荐理由
对于从事围手术期药物或器械临床研究的注册与医学事务人员,了解数据库整理思路有助于提升数据质量,确保监管申报数据的可靠性。建议相关团队参考其方法,优化自身数据管理流程。
五维评分
正文
熟悉我们的朋友都知道,我们团队研发过横断面数据的Nhanse平台和队列数据的老年数据库平台。然而,Nhanse指标虽多,但是横断面的研究设计影响结论的证据强度,而老年数据库的临床指标和疾病诊断资料又很少,不利于开展临床医学研究。
两个月前,我们团队开始将目光投入到围手术期数据库,Inspire数据库。它是一个来自真实临床实践中产生的具有丰富医疗信息的韩国纵向数据库。这类数据库的临床指标丰富性和复杂性明显高于以往我们所接触的Nhanse和Charls这类数据库。
在一个多月的开发过程中,郑老师与我们反复讨论平台的设计逻辑,不得不说,这是目前我们做过最贴合实际分析需求且难度最高的数据提取平台。如果你也在寻找公共数据库研究的新思路,不妨花点时间看看下面的内容。
INSPIRE数据库的核心优势
INSPIRE数据库的信息来自真实的医疗实践与监测,因此在研究临床问题,尤其是小众的临床领域,INSPIRE具有它独特的优势:
数据覆盖临床全流程
它不是单纯的术中监测数据库,也不是单纯的 ICU 数据库,而是覆盖入院前、住院期间(入院后、术中、术后、ICU等)及出院后整个临床流程的数据库。
适合多种分析需求
它包含人口学特征、疾病诊断、手术类型、麻醉、生命体征、实验室检测、服用药物等多种临床信息,非常适合开展关联性研究、因果分析和机器学习预测模型研究。
数据规模较大
数据库以一次手术为最小单位,纳入约 13 万例手术记录,除了常见的全因死亡、住院28天死亡这类结局外,庞大的样本量使得研究者还可以开展罕见人群、罕见疾病和罕见干预研究,例如等。
多个维度的ID识别符
INSPIRE 提供 subject_id、hadm_id、op_id 三层 ID,适合处理患者、住院和手术之间的复杂关系。
术中高频生命体征
术中生命体征和麻醉机参数是围术期研究中的核心数据。INSPIRE 提供了密集的术中监测数据,使得研究动态指标成为可能。
纵向监测数据
除个别基线特征外,绝大多数指标带有时间数据,满足复杂的纵向分析和生存分析的需求
公开可申请使用
相比医院内部数据,INSPIRE 对研究者更加友好。只要同意相应的数据使用协议,研究者就可以申请访问。
INSPIRE数据库的核心
使用 INSPIRE 时,必须理解它的时间表达方式。
为了保护患者隐私,INSPIRE 不提供真实日期时间,而是使用相对时间。
官方说明中,所有带 _time 的变量均被转换为相对于某个时间零点的分钟数。
这意味着数据中的时间变量不是:2020-05-01 08:30这样的形式
而是一个数值:如1258,表示距离首次入院时间点第1258分钟。
这种处理可以降低再识别风险,但也却显著增加了整理数据的难度,这要求使用者捋顺多次住院的时间线,结合各个关键时间点,去判断当前这个数据究竟发生在哪次住院的哪个阶段。
为此我们人为地将整个住院过程,基于几个数据集中提供的关键时间点进行划分,形成了易于理解的六个临床阶段。
每行数据,事先根据它的数据时间进行时间阶段判定
例如:
入院前:数据时间 < 入院时间入院到手术开始:入院时间 < 数据时间 <= 手术开始时间手术期间:手术开始时间 < 数据时间<= 手术结束时间手术结束到出院: 手术结束时间 < 数据时间 <= 出院时间ICU 期间:进ICU时间 < 数据时间 <= 出ICU时间出院后:数据时间 >出院时间
对于多次住院,还要进一步判断事件到底属于哪次住院,往往选择保留首次住院数据进行分析。若研究设计具体手术类型,还需区分一次住院开展多次手术的患者。
这也是 INSPIRE 数据整理中最容易出错的地方。
INSPIRE数据库的一个关键难点
INSPIRE 的数据结构允许一个患者对应多次住院,一个住院对应多台手术。
这带来了一个重要问题:
同一条实验室检查、诊断或药物记录,到底应该匹配到哪台手术?
例如,某患者一次住院期间做了两台手术:
第 1 台手术:第 2 天
第 2 台手术:第 8 天
如果某个检验值出现在第 5 天,那么它对于第 1 台手术可能属于“术后”,但对于第 2 台手术可能属于“术前”。
因此,INSPIRE 的分析不能只做简单的 left_join(),而需要按时间区间进行阶段化整理。
一种更合理的整理方式是先以 operations 表建立阶段索引,例如:
全人群阶段:
入院前
入院到手术开始
手术开始到手术结束
手术结束到出院出院后ICU 人群阶段:
入院前
入院到手术开始
手术开始到手术结束
手术结束到入 ICU
ICU 期间
ICU 出科到出院出院后然后再把 生命体征、实验室检测、用药、诊断等表按 subject_id + hadm_id + op_id + 时间区间 进行匹配。
这样才能得到真正适合分析的数据集。
为什么我们要做 INSPIRE 数据整理平台
可见INSPIRE是一个使用价值很高的宝藏数据库,但使用门槛也不低。
很多研究者下载数据后,首先遇到的并不是统计建模问题,而是数据整理问题。除了刚才提及的时间匹配及重复住院、重复手术问题之外,还有一系列问题:
例如:
怎么把 operations和labs合并?多次手术患者如何判断术前和术后? 生命体征如何提取均值、最大值、最小值或首次值? 诊断、药物使用如何转成二分类变量? 如何按时间窗提取数据?
这些问题如果处理不好,后续所有统计分析都会受到影响。
因此,我们围绕 INSPIRE 的数据结构设计了一个阶段化整理思路。
核心思想是:
以最小单位“手术”为锚点,构建每台手术的时间阶段;再把诊断、检验、药物、生命体征等表按阶段匹配进去;最后从研究设计的角度基于“暴露”、“协变量”、“结局”三类数据提取变量。
我们以探究“入院后白蛋白对慢性肾病患者术后住院期间全因死亡的影响”为例,基于我们的平台演示如何快速提取数据
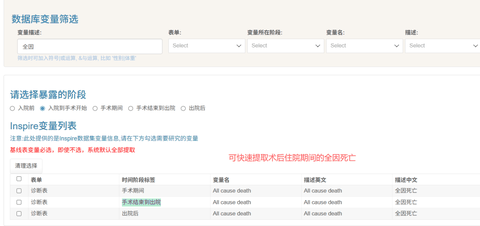
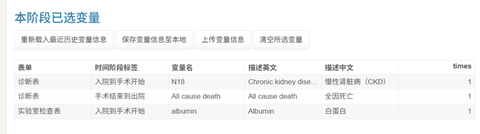
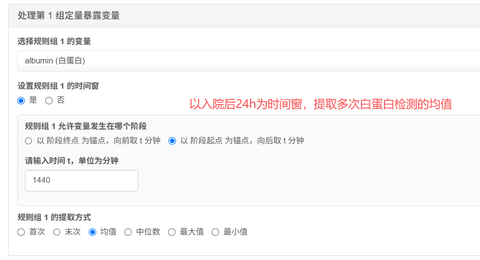
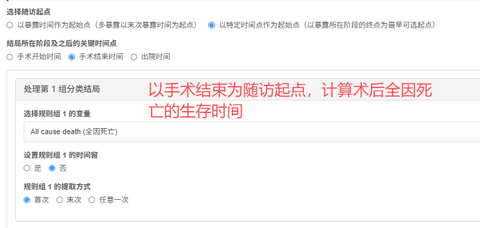
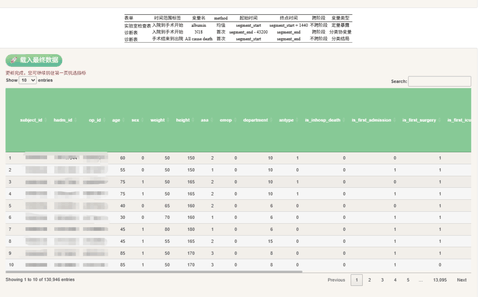
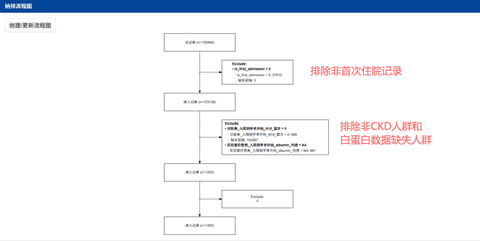
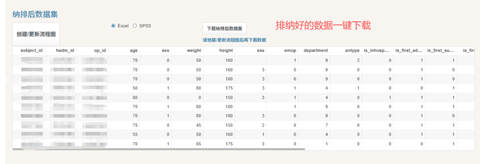
郑老师提出:对很多临床研究者来说,真正的困难不是提出研究问题,而是把原始数据库整理成一张可以分析的表。
因此我们的平台目标就是把这些复杂工作标准化,让研究者更关注研究设计和临床解释,把宝贵的时间用在刀刃上。
INSPIRE整理分析平台