AI for Science中美进展全景复盘:同一起跑线上的暗涌
同一起跑线上的暗涌:AI for Science中美进展全景复盘
摘要
2026年7月31日,E药经理人发布文章,对中美两国在AI for Science领域的进展进行全景复盘。文章指出,两国在基础研究、应用转化及政策支持方面处于同一起跑线,但暗涌涌动,涉及数据、算法、算力及产业生态等关键要素。文章分析了代表性企业、科研机构及监管动态,为医药行业提供了AI驱动研发的宏观视角。
AI 主编 · 推荐理由推荐理由
AI for Science正重塑药物研发范式,注册与研发部门需关注中美差异及政策趋势,以调整AI战略布局。本文提供全景视角,有助于企业预判技术监管走向。
五维评分
正文
当我们站在2026年这个关键的时间节点,来回看全球AI for Science的格局,已经呈现出非常清晰的中美分野。这不是一句空话——上周刚刚在上海落幕的世界人工智能大会,再次将这个话题推到了聚光灯下。真正的问题是:中美之间的差距,究竟是模型能力的差距,是高质量数据供给的差距,还是实验闭环与临床转化能力的差距?中国的场景应用优势能否转化为长期的技术壁垒和全球话语权?在生命科学这样一个跨尺度、强反馈、不断涌现的复杂系统中,中美两条路径哪一条更接近未来?
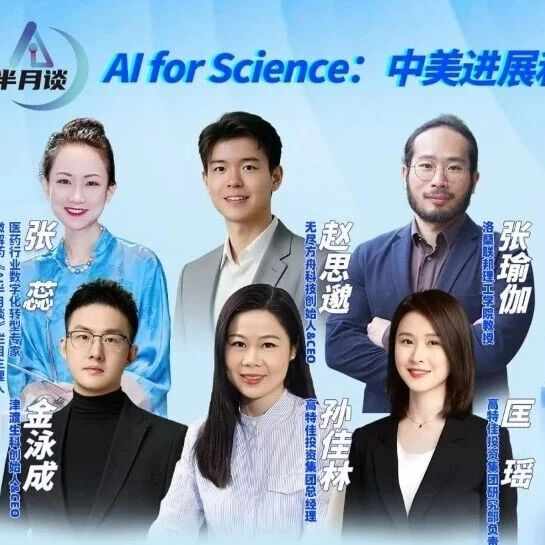
带着这些问题,本期《AI半月谈》邀请了五位来自投资、产业、创业和海外学术前沿的一线嘉宾:高特佳投资集团总经理孙佳林、津渡生科创始人&CEO金泳成、无尽方舟科技创始人&CEO赵思邈、洛桑联邦理工学院教授张瑜伽、高特佳投资集团研究部负责人匡瑶,与主持人张蕊老师同台展开近两小时的深度碰撞。本场直播吸引超27万人次在线观看,创下栏目创立以来新高。
完整版回放已上线【微解药APP】
欢迎扫码观看
一份报告看懂中美AI4S产业全景
从科学模型到物理AI自主发现
金泳成以企业实践展示了从"AI辅助研究"走向"物理AI驱动的自主发现"的路径。他认为,美国优势在算力、基础算法和平台生态,中国优势则在全球最大的应用场景、最完整的CRO产业链和最强的工程交付能力。
他指出当前科研的结构性痛点:工具越来越多,但科研过程并未变得更连贯。科学数据远非自然语言能描述——一个人的基因组文件可能高达30GB。用户需要的不是把复杂数据粘贴到对话框里,而是让系统理解数据、理解研究意图。他提出一种范式变革:从"人提出假设、开展实验"的线性流程,走向"AI主导计算+自动化实验+专家协同"的闭环模式。
津渡生科已构建完整技术体系:GeneLLM多组学预训练大模型作为认知底座(覆盖DNA/RNA/蛋白/代谢跨模态数据,主力版本230亿测试序列、3.5万亿检验数据);BioFold Agent多智能体框架(含文献检索、科学建模、实验设计等六大智能体);以及开发中的BioTide物理世界框架。实验调度智能体已接入多家品牌、多个设备终端,覆盖十余个通用生物实验环节。
金泳成还提出了"Vibe Research"概念——未来研究者可像"氛围编程"一样用自然语言表达目标,智能体组织文献、数据、模型和实验。但科学结论必须回到物理世界验证,Vibe Research必须与Physical AI结合,才能从"生成答案"走向"被发现的事实"。
圆桌讨论分为三轮,分别围绕中美格局分野、应用场景与商业模式、数据监管与跨境协作展开。五位嘉宾从投资、学界、创业等不同视角出发,交锋与共识并存。
一、中美差距的真相:同一起跑线,还是难以逾越的壁垒?
主持人张蕊引用报告中的判断——美国是"基础设施支撑、大药企验证、垂直平台创新",中国是"产业需求牵引、工程交付验证"——抛出了第一个灵魂拷问:这些先发优势在多大程度上构成了难以逾越的壁垒?
张瑜伽教授从欧洲学术界的视角回应了这个问题。他高度认可中国AI for Science的发展速度——"全世界都有高度认可",中国创新药在国际市场竞争力明确,在细分赛道上各有优势,差距并不大。但他指出中国有两个有待提高的方面:
第一是产学研合作的直接性。在欧洲,高校课题组与药企有非常直接的合作——药企发布具体的funding call,研究者可以申请并获得强有力支持,这种合作有多年积累;中国在这方面还不够成熟。
第二是AI科技人才的培养体系。AI是全新领域,如何用新工具做AI for Science开发需要新型科技人才。欧美已有专门的学生培养体系,毕业生更容易直接进入顶尖药企做前沿研究,中国在这方面还有讨论空间。
赵思邈从海外经历回到国内创业的切身体验出发,将中美差异归结为两个结构性因素。他认为AI时代最需要的是人才、算力、数据三样东西。中国基础教育能力并不弱(菲尔兹奖获得者就是例证),但很多人才最终去了美国,根本原因在于美国在学术上的"定义权"——顶级期刊和会议的主办方都在美国,文章署名的大牛也在美国,这形成了学术基础研究的领先性,进而产生人才聚集效应。第二个因素是美国金融能力强,有足够资金和优秀科技公司去孵化世界级领导力和科技壁垒。中国的优势则在数据——不是一手公开数据,而是用户使用后的反馈数据,这些能给模型feedback的数据是未来应用场景上的真正优势。赵思邈的核心结论是:未来是人才的竞争,人才是优先事项。
金泳成的观点更为技术化。他认为中美差距已不再单纯是模型参数或跑分——新模型类型出现后,中国能在2到3个月内追到85至88分(美国90分),单模型性能咬得很紧。真正的代差在两处:一是高质量数据供给,美国在高质量开源生态、AI预测对接自动化实验室方面跑得很快(如Emerald Lab、Recursion等完成近70至80亿美元估值融资);二是物理实验的闭环能力。中国的优势在于产业链完整、上游自动化设备和具身硬件高度发达且成本可控,能够以较低成本较快弥补差距。关键是要把场景数据清洗好、建立高质量数据流水线,形成可复用的数据资产和工程能力。
金泳成还从资源角度补充了一个深层判断:美国资源更充沛,可以容忍一定程度的盲目投入,会持续冒出全新模型品类;中国资源相对有限,所以创业公司更多聚焦工程能力和交付能力,更早在特定场景跑通闭环、产生现金流。这反而是一条更短路径——成本更低、速度更快。"正因为资源有限,所以更要尽早实现流程闭环。"
二、投融资环境:国资主导是过渡还是常态?
在讨论中美差距时,投融资环境的差异自然成为焦点。金泳成提到"中国的资源比较有限",赵思邈也指出美国金融能力强是核心差异之一。作为本土投资方代表,孙佳林的回应颇有分量。
三、量变还是质变:科学领域的"GPT时刻"还有多远?
一个更本质的问题被提了出来:AI在生命科学领域带来的改变,究竟是量变还是质变?
张瑜伽教授的判断较为审慎。他认为AI目前发展才三四年,仍处于非常迅速的发展阶段。量变是无可置疑的——它极大简化了数据分析处理和实验过程,作为工具方便人们解决问题。但能否实现质变,取决于关键科研问题和要解决的具体目标,需要人才、商业化环境、临床验证等多因素交织。总体判断:量变确定,质变有待观察。
金泳成则更为乐观。以2023年初为基准,他认为AI for Science还没有到达质变阶段,仍在"GPT moment"之前。但根据他的行业判断,科学领域的GPT时刻不会太远,可能在未来1到3年之间。质变的关键在于把软件和硬件打通——科学领域需要物理实体验证,当科学智能(智能体加模型)从虚拟世界释放到物理世界,代替双手、双眼和大脑在真实世界执行验证工作时,就会迎来类似Vibe Coding改变软件工程师行业的快速变革。
他描绘了一个令人期待的画面:
未来三年,我们希望在生物、化学、材料实验室里,不再看到戴着蓝色手套的实验员。我们希望看到更多搭载智慧大脑的双臂具身智能和自动化设备,帮助人类去做新的技术、新的知识。
在追问AI更擅长高效探索已知问题还是发现未知机制时,金泳成给出了冷静的分析。他认为主流判断仍然是:大模型目前是一个巨大的"复读机",其高效检索和信息整合能力远大于推理能力。在科学领域有三个具体挑战:第一,科学数据(如多组学数据)不会被训到基模里,只能由基模调用特定科学模型再逐步拼接结果;第二,生物学找的往往是相关性而非因果性——靶点发现、信号通路只能看到"A出现时B出现"的关联,因果关系需要更多深入验证;第三,科学领域基本没有失败数据——所有公开信息都是成功的,导致基于不完整逻辑训练的模型推理能力过度乐观。未来大量负反馈闭环是提升模型推理能力的重要数据来源。
四、世界模型:必要路径,还是概念泡沫?
金泳成在报告中提到了"物理世界模型",这引发了关于世界模型必要性的讨论。赵思邈给出了一个结构清晰的分析框架。
他首先指出,世界模型这个概念目前尚未converge,学界没有统一定义。他将讨论分为宏观和微观两个层面:
宏观世界模型(具身智能用):学界已达成一致——必须把更多物理法则信息输入模型,让它理解物理世界运转规律。只有图像和文字数据,模型很难对精准场景做出预测。赵思邈坦言,"这也是我们因为失败了,所以得出来的经验。"
微观世界模型(生命科学用):存在两派争论。拆分组合派(如DeepMind)主张将复杂问题拆解,分别建模再组合;通用大模型派(如Arc Institute,以及国内做虚拟细胞的公司)则主张用一个通用的能理解微观生命的大模型,模拟各物种、器官、细胞亚型的变化过程。
赵思邈透露,无尽方舟当前的业务聚焦在长寿领域建立虚拟细胞模型,发现物种间保守的逆转衰老基因,进行调控和干预。他坦诚目前尚未完成0到1的闭环,但这个事情也快了。
五、应用场景落地:谁在买单,为怎样的能力买单?
报告梳理了九大应用场景,但真正的问题是:什么样的价值兑现,才会让药企和资本真正买单?
赵思邈从客户B端视角给出了更简洁的判断:要么差异化(模型水平比别人更牛),要么价格更低。他再次强调核心是人才竞争,DeepSeek等公司已经对人才保护采取了很多方法和限制。
在被问及为何选择长寿赛道时,赵思邈的回答出乎意料地感性:
想健康、想长寿,是每个人心底的需求,对我个人而言尤其强烈。我非常希望能够让家里人、让我的朋友也让我自己,能够活到可以选择死亡的时候。我的名字来源于中国药王孙思邈,从小就有健康长寿的初心。从数学建模到统计学时代再到人工智能,方法换了无数次,但人类要解决的核心问题始终是生存和繁衍。
六、数据监管与跨境协作:红线、陷阱与机遇
最后一个话题绕不开敏感问题:在中美两套不同的体系下,数据监管和跨境协作如何影响中国企业的机会与陷阱?
金泳成分享了一线实战经验。津渡生科目前大头收入来自海外,是高度面向全球的公司。他们的核心原则非常清晰:数据完全不跨境。海外业务数据服务器在海外,中国内地数据和服务器在中国内地,确保两套体系完全独立。用于训练模型的数据同样需要严格切割,确保海外模型不涉及任何中国人数据。
金泳成划了一条明确的红线:与人相关的临床敏感数据绝对不能出境。非人的、分子层面的数据目前相对宽松,但工程面仍需谨慎处理。在市场层面,他对美国市场环境持乐观态度——美国对非美企业卖AI应用和产品非常欢迎(苹果App排行榜头部AI应用背后很多是中国团队),未受任何限制。但AI for Science涉及生物敏感数据会更复杂,他建议出海公司在数据合规和规则合规层面"非常小心"。
赵思邈面对"数据可用性还是数据可及性"的极限二选一,毫不犹豫地选择了数据可用性。他解释说,机器学习领域数据噪声影响极大,生物领域更甚——测序深度或数据质量提升10倍,所需数据量可能减少100倍以上。带noise的数据不仅无益,反而影响模型效果。
他进一步区分了两个概念的可解性:可及性是监管或流程问题,可以通过人力解决;可用性得通过治理解决,是从源头上就存在的问题。"可及性其实不算一个问题,可用性才是真正比较稀缺的。"
张瑜伽教授从欧洲视角补充了国际框架的现实:欧洲在数据管理方面非常严格,且只会越来越严格。当前国际合作主要基于共享的公开数据库和open source资源,需要建立双方共同认可的共享框架——这本身很有挑战性,需要研究者、企业和法律层面的协作。但他也给出了一个积极的判断:挑战越大,机遇也越大。监管落后于AI发展速度是常态,企业和研究机构需要提前布局、防范风险。
主持人张蕊用四个关键词总结了全场讨论:范式转变(从经验驱动走向工程化)、闭环能力(高质量反馈数据和智能闭环决定长期价值)、场景兑现("在哪些场景能持续产生可量化价值"才是竞争核心)、中美分野(美国底层领先,中国工程化与产业链优势显著)。
未来1到3年是中国AI for Science企业的关键窗口期,核心命题是三个转变:从应用红利走向能力壁垒,从项目收入走向平台价值,从中国场景走向全球验证。
完整版回放已上线,更多精彩欢迎观看~