当AI智力成本为零时,统计学价值何在?
当AI智力成本是零时,统计学还值钱吗?
摘要
2026年7月13日,医学论文与统计分析(中国)发布文章,探讨AI智力成本趋零背景下统计学的价值。文章指出,AI可低成本完成数据分析,但统计学思维、研究设计、因果推断等核心能力仍不可替代,强调统计学家需转型为AI协作的决策支持者。
AI 主编 · 推荐理由推荐理由
对药企研发和注册人员有启示:AI工具普及后,统计方法选择和合规性仍依赖专业判断,建议关注统计学在监管申报中的不可替代性,避免过度依赖AI导致分析缺陷。
五维评分
正文
前段时间,老郑用AI五分钟生成了一份样本量估算,效应量、α值、把握度一应俱全,引用的文献格式比我自己整理的还规范。
但我盯着那个数字,总觉得不对。
查了二十分钟发现问题所在。
AI选的那篇参考文献,单中心、样本量六十、入排标准和我想要完全是两个人群。用它报告的效应量来算样本量,等于是拿一把不准的尺子去量下一块布。
这个瞬间让我想清楚了一件事,AI把“算”的成本打到了零,但“算之前该想什么”和“算完了能信多少”,这两件事反而更贵了。
AI替我们解决了什么?
医学统计里有大量工作确实适合AI。
数据清洗、描述性统计、Table 1生成、标准图表输出、方法学段落撰写——这些操作层的工作,过去占掉大量时间,现在AI几分钟就能完成。
问题在于,这从来不是统计学的核心。
任何一个做过实际项目的人都知道,跑出结果是最后一步。在这之前和之后的事,才是统计学真正起作用的地方。
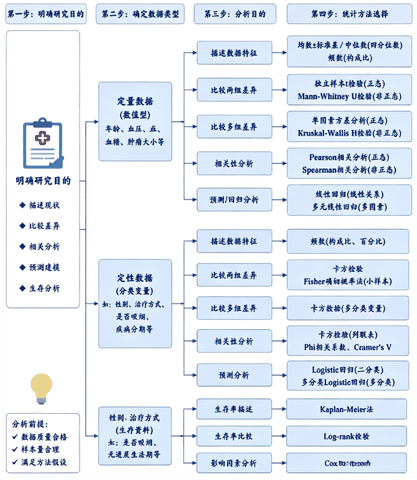
统计分析流程(图源网络)
√研究设计
研究设计的本质,是在数据还没出现之前,就定好怎么收集、怎么分组、怎么分析、用什么做主次要终点。
这些决定一旦错了,后面跑再多模型都是精确地犯错。
主要终点选什么?全因死亡还是疾病特异性死亡?PFS还是OS?复合终点里哪些事件应该放进去、哪些不应该?
这些选择没有任何算法能替你做出,因为算法只能回放已有的研究,而你要做的是一个还不存在的试验。
随机化分层因素怎么选?年龄、性别、基线严重程度,还是把研究中心也放进去?放多了消耗自由度,放少了怕不平衡。
AI能列出一份文献中常用的分层变量清单,但它不知道在你这个具体的研究人群里,哪些变量真的和主要终点强相关。
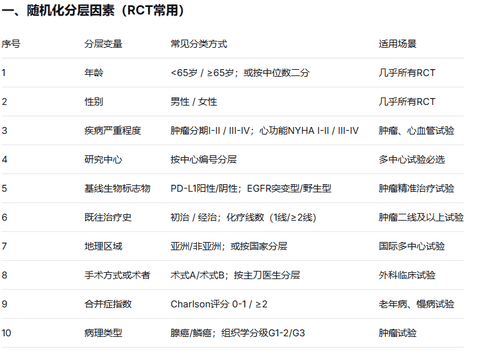
这些决策都是在黑暗中画地图。AI没有见过你还没开始的研究,它没法替你画。
AI可以跑出格式完美的统计分析报告,方法规范,结果完整。但它不会在结果反常时告诉你:“这个数字不合常理,你得回头查一下。”
我见过一个案例。
某试验的期中分析显示,试验组严重不良事件发生率异常低,统计学上显著低。AI会忠实地报告这个差异,附上p值和置信区间。
但一个有经验的统计师会立刻警觉:严重不良事件报告率异常低,往往不是药物安全性好,而是漏报。这是数据质量问题,不是疗效信号。
这种警觉从哪里来?来自于你亲手处理过真实世界的脏数据,知道缺失值不会随机出现、知道中心效应可能藏污纳垢、知道数据录入错误的长相和真实离群值完全不同。
AI的训练素材是清洗过的文献数据和教科书示例,它对“脏”没有概念。
p<0.05,差异有统计显著性。AI到这一步就算完成任务了。
但临床医生问的是另一个问题:这个结果对患者有意义吗?
降压药降低收缩压3mmHg,p<0.001,统计学上稳如泰山。
但如果换成复合心血管事件终点,事件率从10%降到9.6%,NNT超过一百。为了这3mmHg,患者要多服一种药、多承担一份不良反应风险、多花一份钱,值吗?
这不是一个统计学问题,但这是一个只有懂统计的人才能精确拆解的问题。
效应值的置信区间有多宽?获益的不确定性有多大?不良反应的罕见事件能不能被现有样本量捕捉到?
AI能给出数字,但它不知道这个数字在临床决策的天平上,是重如泰山还是轻如鸿毛。
贬值的是操作,升值的是判断
对于医学统计从业者来说,这轮变化的边界非常清晰。
在样本量计算的这件事当中,贬值的是代入公式这个动作,升值的是选择效应量时的审慎。
从哪篇文献找依据?它的质量够不够?它的人群和你的可交换吗?要不要做保守估计,把效应量往下调一点看样本量涨多少?
而在整个统计分析过程当中,贬值的是跑出结果这个操作。升值的是看到结果时的那份警觉。
随着技术的发展,AI把从数据到结果那段路铺成了高速。
那就没必要在高速上和人比赛谁跑得快。真正该站的位置,是高速的两头。
入口这一头是分析之前,研究问题还没变成数据,我们要在设计这一步下足功夫。在设计阶段堵住偏倚、定义清楚终点、写好统计分析计划。这些决策一旦做对了,AI才能在正确的轨道上跑。
出口那一头是结果判断,AI把结果摆到桌面上之后,我们就要开始发问了。
结果稳健吗?能外推到目标人群吗?对临床决策到底意味着什么?
这些问题没有算法能回答,因为它们本质上是在评估“这个结果该被相信到什么程度,据此行动的风险有多大”。
不是统计学需要AI,是AI的结果需要统计学
AI最大的风险,不是替代统计师。是让没有统计基础的人,以为自己会做统计了。
一键生成分析方法严谨、结果漂亮的报告。效应量选错了看不出来,混杂没控干净看不出来,多重比较没校正看不出来。
越是这种时候,真正懂统计的人越不可替代。
因为只有你能在所有人都点头的时候,指着表格里的某一行说:“这个数字可能有问题。”
这句话,AI永远说不出来。它不知道自己算出的结果里,哪些是信号,哪些是漂亮的噪声。
Token成本趋零,对医学统计来说不是危机,是剥离。
把耗时间的操作层剥离掉,让统计师的时间回到真正需要专业判断的地方:研究开始前定义问题,数据出来后判断可信度,临床决策前把数字翻译成决策依据。
这些工作没有公式可套,每一次都是面对一个独一无二的研究、一群独一无二的患者、一个没有标准答案的判断。
AI用Token算出概率。统计学告诉你这个概率意味着什么。
而你,要为你所判断的“意味着什么”负责到底。这永远是无价的。
关于郑老师团队及公众号
全国较大的医学统计服务平台,专注于医学生、医护工作者学术研究统计支持
郑老师团队可以提供诸多统计支持:
详情联系助教小董咨询(微信号aq566665)