开源工具实现因果推断全自动化 一分钟出结论
我们发现了一款能把因果推断全自动化的开源工具,一分钟就能跑出因果结论
摘要
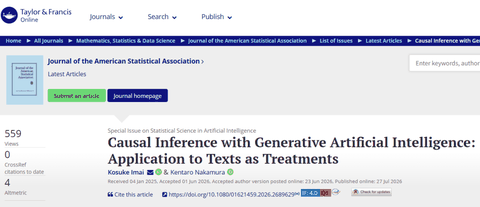
2026年8月,医学统计平台“风暴统计”介绍一款基于大语言模型的开源因果推断工具,其方法学文章发表于期刊《Journal of the American Statistical Association》。该工具宣称可自动完成因果推断分析,一分钟内输出结论,旨在降低统计门槛,提高研究效率。适用于临床研究及真实世界数据因果分析场景。
AI 主编 · 推荐理由推荐理由
因果推断是真实世界证据与上市后研究的关键方法,此工具或可提升分析效率。建议研发与医学事务团队评估其方法学可靠性及合规适用性。
五维评分
正文
源自风暴统计网:一键统计分析与绘图的网站
全称Generative AI-Powered Inference,即"生成式人工智能驱动的因果推断"。
当我们想要估计文本某个特征对临床结局的因果效应(比如出院小结里是否提到"发热"),会受到大量混杂信息的影响(例如基础病史、用药、检查结果等),这些信息可能既影响结局,又与我们的暴露相关。
传统的做法是把文本转成数值向量,然后把学到的向量作为协变量纳入模型去调整混杂。
可问题在于,这个学出来的向量很可能包含了处理特征本身的信息。
拿着它几乎能完美预测分组,导致因果推断中关键的重叠假设被严重违反,估计结果不可信。
√GPI的解决思路
为了针对性解决这个问题,研究团队不再从数据中"猜"文本的数值表示,而是直接从大语言模型(LLM)内部把真实的向量表示拿出来用。
也就是说,当我们用Llama这类开源大模型生成或复现文本时,模型内部会产出一个高维向量,也就是模型对这段文本的"理解笔记"。
在此基础上,研究团队专门训练一个神经网络,从这份"理解笔记"里专门摘出一个去混淆子,只保留能影响结局、但跟分组无关的那部分混杂信息。
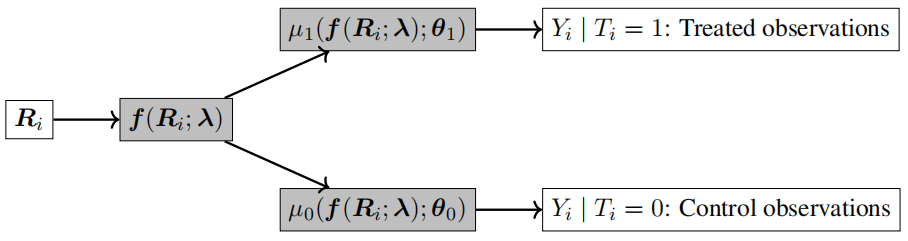
关键是,这个去混淆子在学习时被严格约束——不能用来预测处理变量,从而保证了重叠假设成立。
√一个必须满足的前提:可分离假设
要想使用GPI,数据必须满足可分离假设,即文本里你关心的特征和混杂特征,没有在文本中"捆绑"在一起。
举个例子,如果"发热"和"感染"在病历里永远同时出现,就很难单独改变"发热"而不改变"感染"的信息。
如果这个假设不成立时,GPI的估计也会失效。
√GPI性能优于传统方法
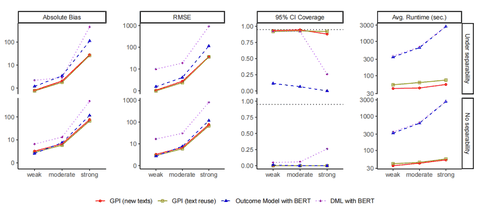
研究团队在候选人传记数据上进行了模拟试验,把GPI和基于BERT的两类方法做了对比。
结果显示,当可分离性成立时,GPI的偏差和均方根误差都明显更小,95%置信区间覆盖率也稳定在名义水平。
在强混杂场景下,基于BERT的方法严重偏离真值,GPI依然保持了较好的表现。
但当可分离性被违反时,GPI的估计也会出现明显偏差,说明它不是万能工具。
进一步,研究团队在真实数据上进行了验证,估计"候选人是否有军事背景"对选民好感度的因果效应。
GPI估计得到的平均处理效应(ATE)为4.85,即军事背景平均能提升4.85分好感度。
而基于BERT的两种方法,一个给出负效应(-4.28),另一个给出45.71分,后者评分范围只有0到100,这个数字显然不合理。
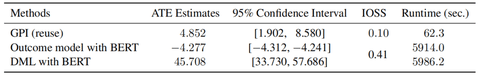
计算效率上,GPI以秒为单位,BERT方法需要数分钟,差距达百倍。
√如何使用GPI
研究团队已经把方法封装成了开源的Python包,链接放在这里,感兴趣的可以自己装来试试,网址:https://gpi-pack.github.io/。
不过在试用之前,建议先跑一遍他们推荐的诊断检查。看看倾向得分分布有没有极端值,算一下IOSS指标判断可分离性是否合理。
这些步骤花不了多少时间,但能帮你判断这个方法在你的数据上到底站不站得住。
我们在进行因果推断的时候,最害怕的是存在未知或不可测的混杂因素,让效应估计产生偏倚。
这也是为什么推荐大家在做研究之前先画好有向无环图,理清楚变量之间的因果结构,搞清楚哪些该调、哪些不该调。
但对于文本数据,这套流程很难直接套用。因为文本里同时包含了成百上千个特征,你无法提前在DAG里逐一标注哪些是处理因素、哪些是混杂、哪些是中介。
你甚至不知道文本里到底有多少个"变量"在同时起作用。
这样一来,传统做法就陷入两难:
要么把所有文本特征都作为协变量调整,但这样做很可能引入“坏的控制变量”,比如中介或撞节点,反而制造偏倚;
要么干脆不做调整,但混杂带来的偏倚又无法交代。
所以我认为,处理文本做因果推断,一个可靠的方法至少要做到两件事。
一是要把文本转成某种可操作的结构,但不能靠“猜”——你不能把一个黑箱模型吐出来的向量直接拿去当协变量,因为你看不到里面混杂和处理的纠缠关系。
二是要在因果结构上做明确的分流,把哪些信息用于调整、哪些信息用于估计处理效应,从一开始就分开。
GPI在这两点上确实做到了。它没有回避“文本里有混杂”这个事实,而是用大模型内部已经存在的表示,再通过去混淆子把混杂信息单独拎出来。
这个思路,我觉得是往前走了一步。
但它却不是万能解法。可分离性这个前提,在真实临床文本里其实挺难满足的。
病历里的词从来不是独立出现的,"发热"和"感染"在病程记录里几乎永远是绑在一起的。
方法本身没问题,但适用场景可能期望的还要窄。
关于郑老师团队及公众号
学统计就找郑老师团队,我们有全面的医学统计课程!
1.医院临床数据分析课程
临床试验(RCT)研究设计与数据分析;临床预测模型和基于R语言/Python的机器学习方法在临床预测模型中的应用(附赠全套代码);医院回顾性数据与真实世界临床研究,涵盖目标模拟试验(模拟RCT)、缺失数据填补下真实世界研究、倾向性评分方法(包括倾向性得分匹配、逆概率加权,重叠加权)等
2.纵向数据分析课程
3.公共数据库挖掘与分析课程
NHANES(美国国家健康和营养检查)公共数据库、GBD(全球疾病负担)公共数据库、七大老年健康数据库挖掘与分析课程;孟德尔随机化方法快速发表SCI初级班、高级班以及进阶攻略:整合网络药理学&单细胞测序
4.其他课程
需以上统计课程,请联系郑老师团队(微信:aq566665)